3.8.-Pruebas de funcionamiento del despliegue
3.8. Pruebas de funcionamiento del despliegue
Idea principal
Una instalación no se considera terminada porque un proceso aparezca como iniciado. Una prueba de funcionamiento define qué se comprueba, cuál es el resultado esperado, qué evidencia se recoge y qué se hace cuando el resultado no coincide.
En este punto se verifica la cadena completa preparada en los temas anteriores. La cadena puede empezar en una máquina virtual o en un recurso de nube, y continuar por la red, el servidor web, el servidor de aplicaciones, la aplicación y los datos. Una prueba debe ser pequeña, repetible y suficientemente concreta para localizar el componente que falla.
La relación normativa exclusiva es:
| Código | Descripción |
|---|---|
| RA1 | Implanta arquitecturas web analizando y aplicando criterios de funcionalidad. |
| CE f | Se han realizado pruebas de funcionamiento de los servidores web y de aplicaciones, y de tecnologías de virtualización en la nube y en contenedores. |
Qué deberías saber al terminar
Deberías poder:
- convertir un requisito en una prueba con resultado esperado;
- comprobar estado, puertos, HTTP, comunicación interna y persistencia;
- registrar evidencias e interpretar una incidencia sin cambiar varias cosas a la vez.
Mapa del tema
Definiremos una prueba, seguiremos capas desde el entorno hasta la aplicación, consultaremos evidencias y cerraremos con un informe.
1. Qué es una prueba de funcionamiento
Una prueba relaciona una condición inicial, una acción, un resultado
esperado y una evidencia. Por ejemplo, si Nginx debe publicar la
aplicación en el puerto 80, la acción puede ser solicitar /health y el
resultado esperado puede ser una respuesta 200 en menos de un tiempo acordado.
Prueba de funcionamiento
Comprobación planificada que aporta evidencias sobre si un servicio o una cadena de servicios cumple una condición definida en un entorno concreto.
Una evidencia es el dato que demuestra qué ha ocurrido: una captura, la salida de un comando, una respuesta HTTP o una línea de registro. Cuando probamos la cadena de extremo a extremo, comprobamos el recorrido completo desde el cliente hasta la aplicación y los datos, no solo que un proceso esté encendido.
No es suficiente con escribir «funciona». Hay que indicar desde dónde se lanza la prueba, qué versión se está utilizando y qué respuesta se considera correcta. Una prueba puede ser manual durante el aprendizaje, pero debe poder repetirse.
1.1. Del requisito al caso de prueba
El punto de partida no es el comando, sino el requisito. Si el requisito es «la aplicación debe estar disponible a través de Nginx», hay que convertirlo en una condición que se pueda observar. Un caso de prueba completo responde, como mínimo, a estas preguntas:
| Campo | Pregunta que responde | Ejemplo |
|---|---|---|
| Precondiciones | ¿Qué debe estar preparado? | Servicios iniciados y red creada |
| Origen | ¿Desde dónde se comprueba? | Cliente autorizado, no el contenedor |
| Acción | ¿Qué se ejecuta o solicita? | curl contra /catalogo/health |
| Resultado esperado | ¿Qué significa que pasa? | HTTP 200 y contenido válido |
| Evidencia | ¿Qué se conserva? | Orden, hora, respuesta y logs |
| Limpieza | ¿Qué se revierte al terminar? | Borrar el dato sintético creado |
El resultado esperado debe ser observable y medible. «La página se ve
bien» es demasiado ambiguo; «la URL responde con 200, contiene el texto
Catálogo y no supera diez segundos» permite que otra persona repita la
comprobación. Si un requisito no puede traducirse a una observación, todavía
no está suficientemente definido para probarlo.
Un caso concreto
Para comprobar la publicación de una aplicación Java, se puede definir el
caso T04 así: con Nginx y Tomcat iniciados, desde el cliente autorizado se
solicita en un laboratorio local http://localhost/catalogo/health; se
espera HTTP 200, un cuerpo válido y una entrada correspondiente en los
registros de Nginx y Tomcat. La prueba no queda cerrada hasta guardar el
resultado y la hora.
2. Diseñar una matriz de pruebas
Una matriz es una tabla que relaciona cada comprobación con su resultado esperado y con la evidencia que debemos guardar. Ayuda a no olvidar los niveles del despliegue:
| ID | Elemento | Acción | Resultado esperado | Evidencia |
|---|---|---|---|---|
| T01 | Instancia o VM | Consultar estado y acceso | Recurso activo y accesible con la cuenta prevista | Panel o comando del proveedor |
| T02 | Contenedor | Consultar servicios | Contenedores activos y saludables | docker compose ps |
| T03 | Red | Resolver el servicio interno | El nombre y el puerto responden desde la red autorizada | curl o nc |
| T04 | Nginx | Solicitar la URL pública | Código y contenido esperados | Respuesta HTTP y navegador |
| T05 | Tomcat | Solicitar el contexto de la aplicación | Aplicación desplegada y respuesta válida | curl y logs |
| T06 | Persistencia | Reiniciar el servicio | Los datos definidos como persistentes siguen disponibles | Comparación antes y después |
La matriz no tiene que probarlo todo en un único paso. Primero se comprueban las dependencias más cercanas al fallo y después se realiza una prueba de extremo a extremo.
2.1. Tipos y orden de las pruebas
No todas las comprobaciones tienen el mismo alcance. En un despliegue pequeño conviene avanzar de lo más barato y cercano al fallo a lo más completo:
| Tipo | Qué comprueba | Ejemplo |
|---|---|---|
| Humo | Que el servicio arranca y responde mínimamente | /health devuelve respuesta |
| Integración | Que dos componentes se comunican | Nginx alcanza app:8080 |
| Funcional | Que una operación produce el resultado esperado | Consultar el catálogo |
| Extremo a extremo | Que funciona el recorrido completo | Cliente → Nginx → Tomcat → datos |
| Recuperación | Que el servicio vuelve a funcionar tras un cambio | Recrear el contenedor y consultar |
| Negativa | Que un fallo controlado se detecta correctamente | Backend detenido y 502 esperado |
Una prueba negativa no consiste en romper un entorno sin control. Se prepara
una condición reversible, se anota el resultado esperado y se restaura el
servicio al terminar. Por ejemplo, esperar un 502 al detener Tomcat puede
confirmar que Nginx detecta la indisponibilidad del backend, pero no demuestra
que la aplicación esté operativa.
3. Comprobar el entorno y los servicios
En una máquina virtual o instancia cloud se comprueban el estado del recurso, el acceso administrativo, la dirección y las reglas del firewall. El firewall es el conjunto de reglas que permite o bloquea comunicaciones. Nunca se debe pegar una clave privada ni un token, que es un valor secreto usado para demostrar que una persona o programa tiene permiso, en el informe.
En un entorno Docker, una primera comprobación puede ser:
docker compose ps
docker compose images
docker compose logs --tail=50 web
docker compose logs --tail=50 app
docker stats --no-stream
El estado running solo indica que el proceso principal no ha terminado. Un
healthcheck es una comprobación automática, como solicitar /health, que
indica si el servicio responde. Puede añadir una señal útil, pero debe estar
bien diseñado y no sustituye a una petición funcional completa.
Para revisar puertos en el anfitrión:
docker compose port muestra qué puerto del host está asociado al puerto del
servicio. El comando docker port también sirve si se conoce el nombre real del
contenedor, pero en Compose ese nombre puede incluir el proyecto y el índice de
la réplica. Compara lo observado con la ficha de requisitos. Un puerto abierto
no demuestra que la aplicación responda correctamente; solo indica que hay algo
escuchando.
3.1. Elegir el origen de la prueba
El lugar desde el que se ejecuta la comprobación forma parte del caso. Desde el
propio servidor, localhost prueba la interfaz local; no demuestra que el
firewall, el DNS ni la ruta pública permitan el acceso de una persona usuaria.
En una instancia cloud conviene separar al menos estos orígenes:
- Dentro del contenedor: ayuda a comprobar el proceso y su puerto interno.
- Desde otro servicio de la red interna: comprueba DNS, red y puerto entre servicios.
- Desde el anfitrión o una red autorizada: comprueba la publicación del puerto y las reglas locales.
- Desde el cliente previsto: comprueba la dirección pública, el DNS y las reglas de firewall o del grupo de seguridad del proveedor.
Una aplicación que responde en localhost dentro de Tomcat puede seguir siendo
inaccesible desde Nginx. Del mismo modo, una aplicación que funciona desde la
máquina cloud puede estar bloqueada para el resto de la red. Por eso la matriz
debe registrar el origen y no solo la URL.
4. Probar HTTP y la comunicación interna
Desde el cliente autorizado se puede consultar una respuesta con curl:
curl --include --max-time 10 http://localhost/health
curl --include --max-time 10 http://localhost/catalogo/
Anota el código, las cabeceras relevantes, el tiempo aproximado y una muestra del cuerpo que no contenga datos sensibles. Si Nginx hace de proxy, realiza también una prueba desde su red interna hacia el backend:
docker compose exec web getent hosts app
docker compose exec web curl --include --max-time 10 http://app:8080/health
La herramienta getent puede no estar instalada en todas las imágenes. En ese
caso usa una imagen de diagnóstico temporal o una utilidad disponible en la
red; no instales herramientas permanentes sin documentar el cambio.
getent comprueba la resolución de nombres y curl comprueba además que se
puede establecer una comunicación HTTP. Una orden como nc -z solo demuestra
que el puerto TCP acepta una conexión; no demuestra que Tomcat haya desplegado
la aplicación ni que su respuesta sea correcta. Si el contenedor de diagnóstico
no incluye curl, utiliza una imagen que lo incorpore y registra cuál se ha
usado.
El flujo de diagnóstico se puede representar así:
flowchart TD
  A["¿La instancia o VM está activa?"] -->|No| I1["Revisar proveedor, acceso y firewall"]
  A -->|Sí| B["¿El contenedor o servicio está activo?"]
  B -->|No| I2["Revisar estado y logs"]
  B -->|Sí| C["¿El puerto y el DNS responden?"]
  C -->|No| I3["Revisar red, publicación y nombres"]
  C -->|Sí| D["¿HTTP devuelve lo esperado?"]
  D -->|No| I4["Revisar Nginx, Tomcat y aplicación"]
  D -->|Sí| E["Registrar evidencia y resultado"]
5. Aplicar las pruebas y conservar evidencias
5.1. Interpretar resultados y registros
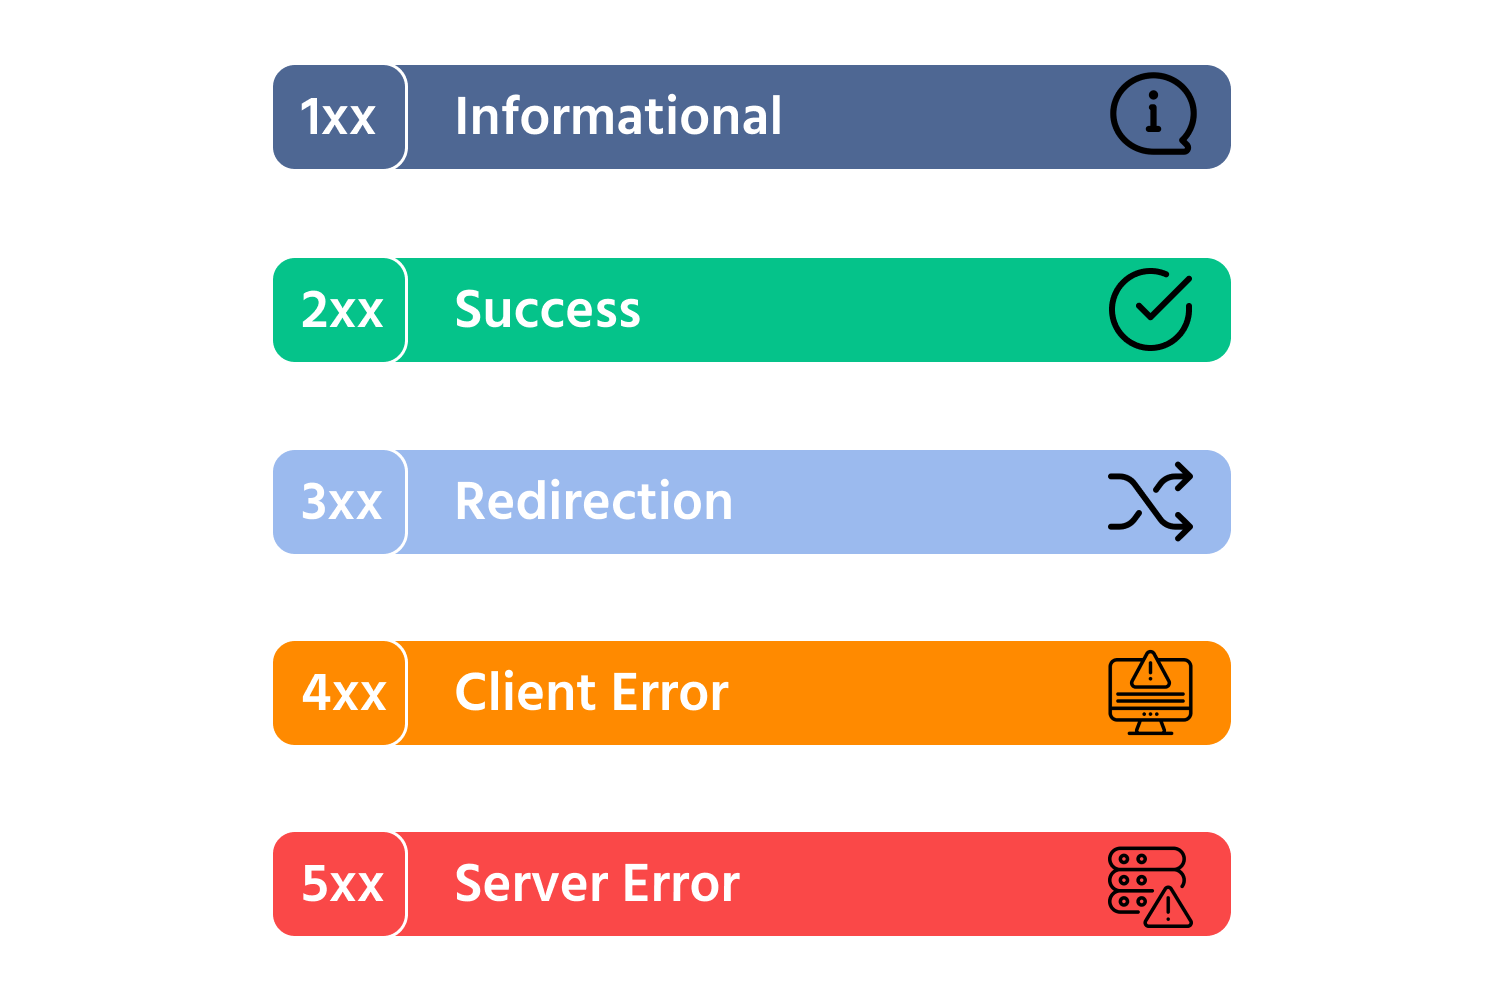
Los códigos HTTP ayudan a localizar el problema, aunque no sustituyen a los logs:
2xx: la petición se ha procesado correctamente según el servidor;3xx: hay una redirección que también debe comprobarse;4xx: el destino, el recurso o los permisos de la petición no son correctos;5xx: ha fallado el servidor o un componente intermedio.
Un 502 Bad Gateway suele indicar que Nginx no puede comunicarse con el
backend; un 404 Not Found puede indicar una ruta incorrecta o una aplicación
no desplegada en el contexto esperado. Un 3xx no es automáticamente un éxito:
hay que comprobar la cabecera Location y decidir si la redirección forma parte
del comportamiento esperado. Un 4xx puede ser el resultado correcto de una
prueba negativa, por ejemplo al comprobar que una ruta protegida rechaza a una
persona no autenticada. Revisa los registros de cada componente en el mismo
intervalo temporal:
Para observar el código y el tiempo de una petición sin ocultar una respuesta de error, se puede usar:
curl --silent --show-error --include --max-time 10 \
  --write-out '\nHTTP=%{http_code} TIME=%{time_total}s\n' \
  http://localhost/catalogo/health
No añadas --location sin decidirlo antes: seguir una redirección puede ocultar
que la primera respuesta no era la esperada. Guarda la hora, la orden ejecutada,
el origen, el resultado y la interpretación. Si una prueba falla, conserva el
primer estado fallido antes de realizar cambios.
5.2. Probar persistencia y recuperación básica
Si la aplicación utiliza datos persistentes, crea un dato de prueba no sensible, reinicia el servicio y comprueba que el dato sigue disponible. Distingue entre reiniciar un proceso, recrear un contenedor y eliminar un volumen: no tienen el mismo efecto.
Una comprobación sencilla puede documentarse con esta tabla:
| Momento | Operación | Dato visible | Resultado |
|---|---|---|---|
| Inicial | Crear registro de prueba | Sí | Línea base |
| Cambio | Recrear el servicio sin borrar volumen | Pendiente | Debe mantenerse |
| Final | Consultar de nuevo | Pendiente | Comparar con la línea base |
No uses información personal real para una prueba de aula. Si el dato no persiste, registra si se esperaba que fuera efímero o si existe un defecto de configuración.
5.3. Healthchecks y disponibilidad real
Un healthcheck automatiza una comprobación pequeña y permite que Compose
marque un servicio como healthy o unhealthy. No sustituye a la prueba
funcional: una ruta de salud puede responder aunque la aplicación no pueda
consultar la base de datos o aunque una operación concreta falle.
Un fragmento orientativo es el siguiente:
services:
  app:
    healthcheck:
      test: ["CMD-SHELL", "wget -q -O - http://localhost:8080/catalogo/health >/dev/null || exit 1"]
      interval: 10s
      timeout: 3s
      retries: 5
      start_period: 30s

  web:
    depends_on:
      app:
        condition: service_healthy
    healthcheck:
      test: ["CMD-SHELL", "wget -q -O - http://localhost/catalogo/health >/dev/null || exit 1"]
      interval: 10s
      timeout: 3s
      retries: 5
      start_period: 10s
Las rutas son ejemplos y deben sustituirse por las que realmente ofrezca la
aplicación. Además, la imagen debe contener wget (o la herramienta elegida):
si no lo contiene, el healthcheck fallará aunque el servicio funcione. En ese
caso prepara una imagen con la utilidad o usa una comprobación externa; no
instales paquetes manualmente en un contenedor en ejecución y olvides el cambio.
Comprueba el resultado con:
La propiedad depends_on con service_healthy ayuda a ordenar el arranque,
pero no garantiza que una aplicación permanezca disponible: las peticiones
posteriores deben seguir gestionando errores y reintentos.
5.4. Informe de pruebas
El informe mínimo debe incluir entorno, versión, fecha, persona que ejecuta, matriz de pruebas, evidencias, incidencias y conclusión. Cada incidencia debe tener una descripción reproducible:
ID: INC-001
Prueba: T04
Fecha y hora: 2026-11-01 10:30
Resultado esperado: HTTP 200 en /health
Resultado obtenido: HTTP 502
Contexto: Nginx activo; app reiniciada recientemente
Evidencia: extracto de logs y comando curl
Hipótesis: el proxy no resuelve el nombre app
Acción siguiente: comprobar la red compartida y repetir T03
Estado: abierta
Una incidencia cerrada debe explicar la causa, el cambio realizado y la prueba que demuestra la solución. No se debe convertir un informe de pruebas en una lista de cambios sin evidencia.
El informe puede usar cuatro estados para no confundir una prueba pendiente con una prueba fallida:
- PASS: el resultado observado cumple todo lo esperado.
- FAIL: la prueba se ha ejecutado y no cumple el resultado esperado.
- BLOCKED: no se puede ejecutar por una dependencia o permiso ausente.
- N/A: no se aplica al alcance acordado, con una justificación concreta.
El despliegue se puede considerar verificado cuando las pruebas previstas están
en PASS, las incidencias abiertas tienen una decisión explícita y las
evidencias permiten repetir las comprobaciones sin revelar secretos.
6. Buenas prácticas
- Definir el resultado antes de probar: evita aceptar cualquier respuesta como correcta.
- Probar de dentro hacia fuera: empieza por proceso, red y puerto, y termina con el recorrido completo desde el cliente.
- Aislar cambios: modifica una condición cada vez y repite la prueba que falló.
- Conservar evidencias reproducibles: anota comandos, versiones, horas y resultados sin incluir secretos.
- Probar recuperación: reinicia o recrea los servicios según el escenario y comprueba la persistencia esperada.
7. Errores frecuentes
| Error frecuente | Por qué ocurre | Cómo evitarlo |
|---|---|---|
| Confundir proceso activo con servicio funcional | Solo se mira running |
Haz una petición funcional y revisa su respuesta |
| Probar únicamente desde el propio servidor | Se evita la red real del cliente | Prueba desde el origen autorizado y desde la red interna |
| Cambiar varias configuraciones a la vez | Se intenta resolver rápido | Conserva el primer fallo y modifica una variable cada vez |
| Guardar capturas sin contexto | No se sabe versión, hora o comando | Añade identificador, entorno y resultado esperado |
| Probar con datos reales | Se busca una evidencia rápida | Usa datos sintéticos y elimina el entorno al terminar |
8. Resumen
En este tema has aprendido que:
- una prueba debe tener acción, resultado esperado y evidencia;
- el despliegue se comprueba por capas: entorno, proceso, red, HTTP, aplicación y persistencia;
- los códigos, puertos y logs son evidencias distintas que deben interpretarse juntas;
- un informe de incidencias permite repetir el diagnóstico y verificar la solución.
Idea clave
La pregunta «¿funciona?» solo tiene valor técnico cuando se concreta en una condición que otra persona puede repetir y comprobar.
9. Para seguir practicando
- Ejecuta la matriz de pruebas de Tomcat con Nginx mediante Compose.
- Consulta la práctica de Tomcat con Nginx y transforma sus comprobaciones en casos con resultado esperado.
- Diseña pruebas de persistencia para WordPress con Docker Compose.
Bibliografía y fuentes
- Normativa del módulo 0614.
- Docker: ver logs y estado de contenedores.
- Docker Compose:
healthcheck. - Docker Compose: orden de arranque y dependencias.
- MDN: códigos de estado HTTP.
- Documentación de Nginx: pruebas de configuración.
- José Juan Sánchez: introducción a HTTP.