3.2.-Comunicación web: HTTP y HTTPS
3.2. Comunicación web: HTTP y HTTPS
Idea principal
Un servidor web no se limita a «mostrar una página»: recibe mensajes HTTP, interpreta su destino y responde con un código, cabeceras y contenido. HTTPS añade autenticación del servidor, integridad y confidencialidad mediante TLS.
Después de analizar la arquitectura, necesitamos entender cómo se comunican
sus componentes. Este conocimiento permite interpretar un 404, comprobar un
puerto, leer un log y localizar si el problema está en el navegador, la red,
el servidor web o la aplicación.
Este apunte desarrolla exclusivamente el criterio siguiente:
| Código | Descripción |
|---|---|
| RA1 | Implanta arquitecturas web analizando y aplicando criterios de funcionalidad. |
| CE b | Se han descrito los fundamentos y protocolos en los que se basa el funcionamiento de un servidor web. |
Qué deberías saber al terminar
Deberías poder:
- describir el recorrido de una URL hasta el servidor web;
- distinguir método, cabecera, cuerpo y código de estado;
- explicar qué aporta HTTPS frente a HTTP y comprobar una respuesta con herramientas sencillas.
Mapa del tema
Veremos el recorrido desde DNS y la conexión, la anatomía de las peticiones y respuestas, las cabeceras y el estado, los métodos y códigos, y por último la protección TLS y su comprobación.
1. El ciclo petición-respuesta
Antes de estudiar HTTP, necesitamos aclarar qué significa que el cliente se «conecte» con el servidor. Cuando una persona escribe una dirección en el navegador, no se envía una página completa de forma instantánea. Se realiza un intercambio ordenado entre dos programas:
- El navegador actúa como cliente y solicita un recurso.
- El nombre de la dirección se traduce a una dirección IP mediante DNS.
- El cliente localiza en esa dirección el puerto donde escucha el servidor web y establece una conexión.
- Por esa conexión, el cliente envía una petición HTTP.
- El servidor web recibe la petición, decide cómo atenderla y devuelve una respuesta HTTP.
- El navegador interpreta la respuesta y muestra el resultado o realiza otras peticiones para cargar imágenes, hojas de estilo o datos.
Una conexión es, por tanto, un canal de comunicación abierto durante un
tiempo entre el cliente y el servidor. No es la petición ni la respuesta: la
conexión es el canal por el que se transportan esos mensajes. Por ejemplo, una
petición puede solicitar /productos y la respuesta puede devolver un código
200, unas cabeceras y el contenido de la página.
| Concepto | Qué representa en la práctica |
|---|---|
| Cliente | El navegador, curl o una aplicación que solicita un recurso. |
| Servidor | El proceso que escucha peticiones y prepara respuestas. |
| Dirección IP y puerto | El destino al que debe llegar la comunicación. |
| Conexión | El canal temporal entre cliente y servidor. |
| Petición | El mensaje que indica qué recurso y operación se solicitan. |
| Respuesta | El mensaje con el resultado de atender la petición. |
HTTP es el conjunto de reglas que define cómo se escriben e interpretan las peticiones y las respuestas. Por eso se dice que es un protocolo de la capa de aplicación: describe información cercana a la aplicación, como la URL, el método, las cabeceras y el contenido. No se encarga por sí solo de transportar los bits por la red; para ello utiliza mecanismos de transporte como TCP o QUIC.
En HTTP/1.1, una conexión TCP puede reutilizarse para realizar varios ciclos de petición y respuesta. Así, el navegador no tiene que abrir una conexión nueva para cada imagen o recurso. HTTP/2 permite transportar varios intercambios de forma concurrente sobre una misma conexión, y HTTP/3 utiliza QUIC sobre UDP. Estas versiones mejoran el transporte, pero mantienen la idea funcional básica: un cliente solicita algo y un servidor responde.
Una URL como https://catalogo.example:8443/productos?id=7 contiene:
| Parte | Significado |
|---|---|
https |
Esquema y protocolo seguro |
catalogo.example |
Nombre que debe resolverse a una dirección IP |
8443 |
Puerto explícito; si se omite, HTTPS usa normalmente 443 |
/productos |
Recurso o ruta solicitada |
id=7 |
Parámetro de consulta |
El nombre se resuelve mediante DNS y la conexión utiliza TCP o, en HTTP/3, QUIC sobre UDP. El servidor web escucha en un puerto y decide qué recurso o componente atenderá.
1.1. Cómo leer una URL con criterio de despliegue
Una URL como
https://catalogo.example:8443/productos?id=7#ficha contiene varias partes:
| Parte | Significado |
|---|---|
https |
Esquema que indica HTTP protegido con TLS. |
catalogo.example |
Host cuyo nombre debe resolverse mediante DNS. |
8443 |
Puerto explícito; si se omite, HTTPS usa normalmente 443. |
/productos |
Ruta del recurso o punto de entrada de la aplicación. |
?id=7 |
Consulta (query) con parámetros para esa petición. |
#ficha |
Fragmento para el cliente; no se envía al servidor en la petición HTTP. |
El puerto por defecto de HTTP es 80 y el de HTTPS es 443, pero un servidor
puede escuchar en otro puerto, como 8080 o 8443. Que una aplicación escuche
en un puerto interno no significa que ese puerto esté publicado en Internet:
un proxy puede recibir 443 y reenviar la petición a 8080 dentro de una red
privada.
flowchart LR
  U["Navegador"] -->|"1. Resuelve el host"| D["DNS"]
  D -->|"2. Devuelve una IP"| U
  U -->|"3. Conecta al puerto"| T["TCP o QUIC"]
  T -->|"4. Negocia TLS si procede"| S["Servidor web"]
  S -->|"5. Sirve o enruta"| A["Aplicacion web"]
  A -->|"6. Devuelve datos"| S
  S -->|"7. Respuesta HTTP"| U
El flujo ayuda a diagnosticar: si no se resuelve el nombre, todavía no existe una petición HTTP; si el puerto está cerrado, la aplicación puede estar funcionando pero ser inaccesible; si hay un error TLS, el mensaje HTTP protegido no llega a intercambiarse.
2. Estructura de los mensajes
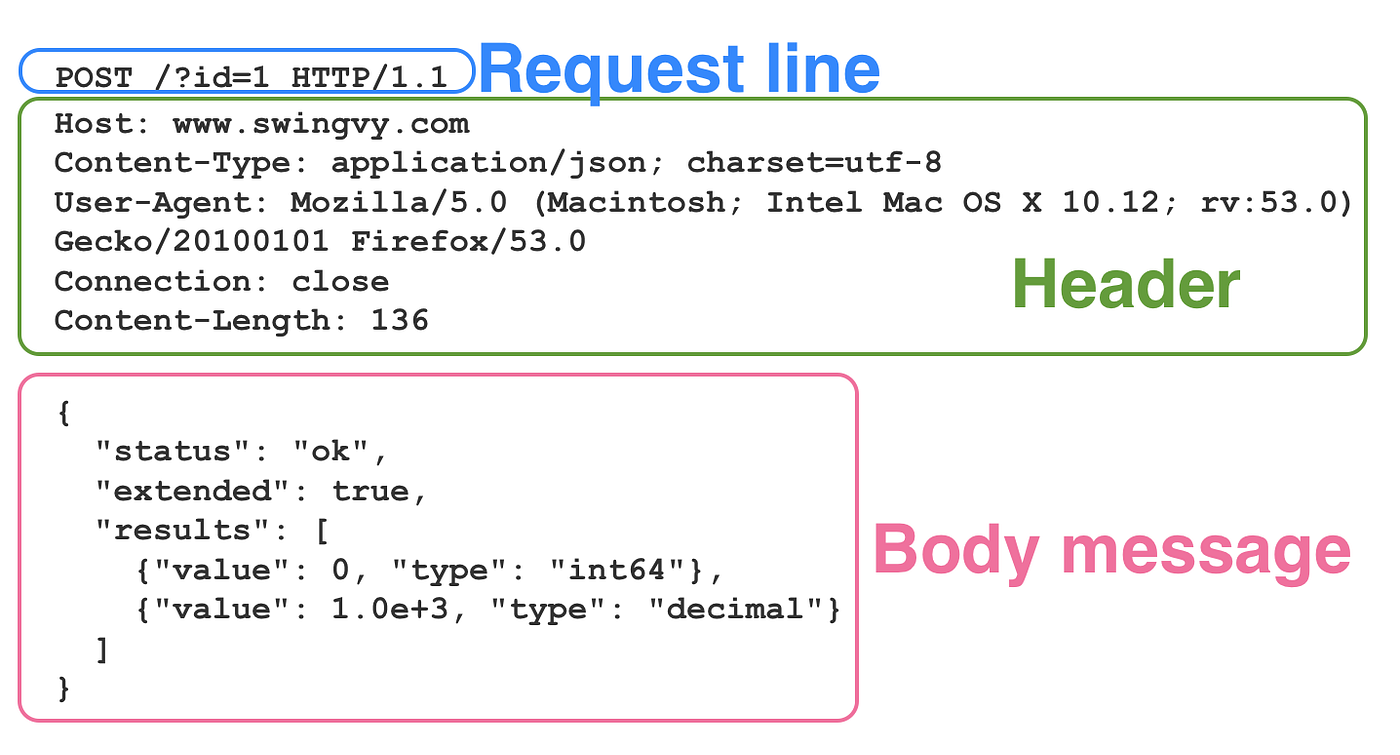
Una petición contiene una línea inicial, cabeceras y, cuando procede, un cuerpo. Por ejemplo:
POST /api/productos HTTP/1.1
Host: catalogo.example
Content-Type: application/json
Accept: application/json

{"nombre":"Teclado","precio":29.90}
La respuesta incluye una línea de estado, cabeceras y contenido:
HTTP/1.1 201 Created
Content-Type: application/json
Location: /api/productos/7

{"id":7,"nombre":"Teclado","precio":29.90}
Host permite que varios sitios compartan una dirección IP. Content-Type
describe el formato del cuerpo. Location indica la dirección de un recurso
creado o redirigido.
En HTTP/1.1, la línea inicial y cada cabecera terminan con CRLF y una línea
vacía separa las cabeceras del cuerpo. Esa separación es significativa: si el
servidor recibe un cuerpo sin reconocer su longitud o su formato, puede
rechazar la petición con 400 Bad Request o 415 Unsupported Media Type.
Los ejemplos de texto que aparecen en este tema representan HTTP/1.1; HTTP/2 y
HTTP/3 mantienen estos conceptos, pero los transportan mediante tramas binarias
y pseudo-cabeceras como :method, :path y :status.
2.1. Ejemplo de una petición GET
Una petición para consultar un producto puede ser así:
GET /productos/7?detalle=ampliado HTTP/1.1
Host: catalogo.example
Accept: text/html, application/xhtml+xml
Accept-Language: es-ES,es;q=0.9
User-Agent: NavegadorEjemplo/1.0
En este caso, GET expresa que se quiere recuperar una representación, la
ruta identifica el recurso, Host permite seleccionar el sitio virtual y
Accept comunica qué formatos puede interpretar el cliente. No hay cuerpo de
petición. El servidor podría responder:
HTTP/1.1 200 OK
Content-Type: text/html; charset=utf-8
Content-Length: 1842
Cache-Control: max-age=60

<!doctype html>
<html lang="es">
  <body><h1>Teclado</h1></body>
</html>
El 200 no significa que todo el proceso de negocio haya sido correcto: solo
indica que el servidor ha generado una respuesta satisfactoria para esa
petición. Para saber qué se ha devuelto hay que leer también Content-Type,
las demás cabeceras y el cuerpo.
2.2. Ejemplo de una petición POST y su respuesta
Para crear un producto, el cliente puede enviar JSON. Content-Type describe
el formato enviado y Accept el formato que espera recibir:
POST /api/productos HTTP/1.1
Host: catalogo.example
Content-Type: application/json; charset=utf-8
Accept: application/json
Content-Length: 35

{"nombre":"Teclado","precio":29.90}
Una respuesta coherente podría ser:
HTTP/1.1 201 Created
Content-Type: application/json; charset=utf-8
Location: /api/productos/7

{"id":7,"nombre":"Teclado","precio":29.90}
201 Created informa de que se ha creado un recurso y Location identifica la
URI desde la que puede consultarse. Si el JSON fuese inválido, el servidor
debería responder, por ejemplo, con 400; si el formato no estuviera soportado,
con 415. No basta con cambiar el método en el cliente: la aplicación debe
validar el contenido, autenticar a quien realiza la operación y autorizarla.
2.3. Qué puede y qué no puede deducirse del mensaje
Un mensaje HTTP permite observar el contrato externo de la comunicación, pero
no revela por sí solo qué ocurrió dentro de la aplicación. Un 200 puede
proceder de Nginx, de una aplicación o de una caché; un 500 puede ocultar
errores diferentes. Para localizar el origen hay que correlacionar la petición
con los registros del proxy, del servidor de aplicaciones y, cuando proceda,
de la base de datos.
3. Flujo desde el cliente al servidor
El proceso completo de una petición de catálogo se puede representar así:
sequenceDiagram
  actor Cliente
  participant DNS
  participant Web as Servidor web
  participant App as Aplicacion
  participant BD as Base de datos
  Cliente->>DNS: Resuelve catalogo.example
  DNS-->>Cliente: Direccion IP
  Cliente->>Web: Peticion HTTP o HTTPS
  Web->>App: Enruta la peticion dinamica
  App->>BD: Consulta datos
  BD-->>App: Devuelve resultados
  App-->>Web: Genera respuesta
  Web-->>Cliente: Codigo, cabeceras y cuerpo
No todas las peticiones llegan a la aplicación: una hoja CSS o una imagen puede ser servida directamente por Nginx. Esta distinción ayuda a leer los logs y a diseñar las pruebas.
3.1. Qué ocurre cuando hay un proxy inverso
En un despliegue habitual, el cliente no contacta directamente con el proceso de la aplicación. Nginx o Apache puede terminar TLS, servir recursos estáticos, aplicar límites y reenviar las peticiones dinámicas a Tomcat, PHP-FPM, Node.js u otro backend. Para el navegador sigue existiendo una única respuesta HTTP, pero el recorrido interno tiene más de un salto.
sequenceDiagram
  actor Cliente
  participant Proxy as Proxy inverso
  participant App as Servidor de aplicaciones
  participant Datos as Base de datos
  Cliente->>Proxy: GET /productos/7
  alt Recurso estatico o cacheado
    Proxy-->>Cliente: 200 y contenido
  else Peticion dinamica
    Proxy->>App: Reenvia la peticion
    App->>Datos: Consulta producto
    Datos-->>App: Resultado
    App-->>Proxy: Respuesta de aplicacion
    Proxy-->>Cliente: Codigo, cabeceras y cuerpo
  end
Este esquema explica por qué el mismo problema puede dejar evidencias en varios registros. El proxy conoce el host, la ruta y el código final; la aplicación conoce las reglas de negocio; la base de datos conoce consultas y errores de persistencia. Una traza o un identificador de correlación facilita relacionar los tres puntos sin registrar datos sensibles.
3.2. El estado de una aplicación web
HTTP se define como un protocolo sin estado: cada petición debe poder interpretarse sin exigir que el protocolo recuerde las peticiones anteriores. Esto no significa que una aplicación no pueda guardar estado. Las sesiones, las cookies y los tokens se utilizan para relacionar peticiones:
HTTP/1.1 200 OK
Set-Cookie: sesion=valor-no-real; Path=/; Secure; HttpOnly; SameSite=Lax
Content-Type: text/html; charset=utf-8

<html>...</html>
En la siguiente petición, el navegador puede devolver la cookie:
Secure limita el envío a HTTPS, HttpOnly dificulta el acceso desde
JavaScript y SameSite reduce algunos envíos entre sitios. Estas opciones no
sustituyen a la autenticación, la autorización, la protección frente a CSRF ni
la gestión segura de sesiones. Nunca se deben usar valores reales de sesión en
ejemplos o registros compartidos.
3.3. Cabeceras y representación del contenido
Las cabeceras son metadatos que permiten negociar, controlar y diagnosticar la comunicación. Algunas habituales son:
| Cabecera | Dirección | Función |
|---|---|---|
Host |
Petición | Selecciona el sitio virtual solicitado; es obligatoria en HTTP/1.1. |
Accept |
Petición | Indica representaciones que el cliente puede procesar. |
Accept-Language |
Petición | Expresa preferencias lingüísticas. |
Accept-Encoding |
Petición | Anuncia compresiones aceptadas, como gzip o br. |
Authorization |
Petición | Transporta credenciales o un token; debe protegerse con HTTPS. |
Content-Type |
Ambas | Describe el formato del cuerpo, por ejemplo JSON o HTML. |
Content-Length |
Ambas | Indica el tamaño del cuerpo en HTTP/1.1 cuando se conoce. |
Cache-Control |
Ambas | Define reglas de almacenamiento en caché. |
Location |
Respuesta | Indica el destino de una redirección o el recurso creado. |
Set-Cookie |
Respuesta | Solicita que el cliente almacene una cookie. |
ETag |
Respuesta | Identifica una versión concreta de una representación. |
If-None-Match |
Petición | Permite preguntar si la representación sigue igual. |
Content-Encoding |
Respuesta | Indica una codificación aplicada al cuerpo, como gzip. |
No hay que confundir Content-Type con Accept: el primero describe lo que
se envía en el cuerpo de ese mensaje y el segundo expresa lo que se acepta como
respuesta. El tipo MIME application/json describe JSON; text/html describe
HTML; image/png describe una imagen PNG.
Una petición condicional puede ahorrar ancho de banda:
Si el recurso no ha cambiado, el servidor puede responder 304 Not Modified
sin repetir el cuerpo. Si ha cambiado, devuelve 200, una nueva ETag y el
contenido actualizado.
El navegador también aplica políticas de origen. CORS permite que un servidor
indique qué orígenes pueden leer una respuesta desde JavaScript, por ejemplo
mediante Access-Control-Allow-Origin. CORS es una política aplicada por el
navegador, no una forma de autenticar a una API ni un cortafuegos que impida
que otros clientes envíen peticiones.
4. Métodos y códigos de estado
Los métodos expresan la intención del cliente:
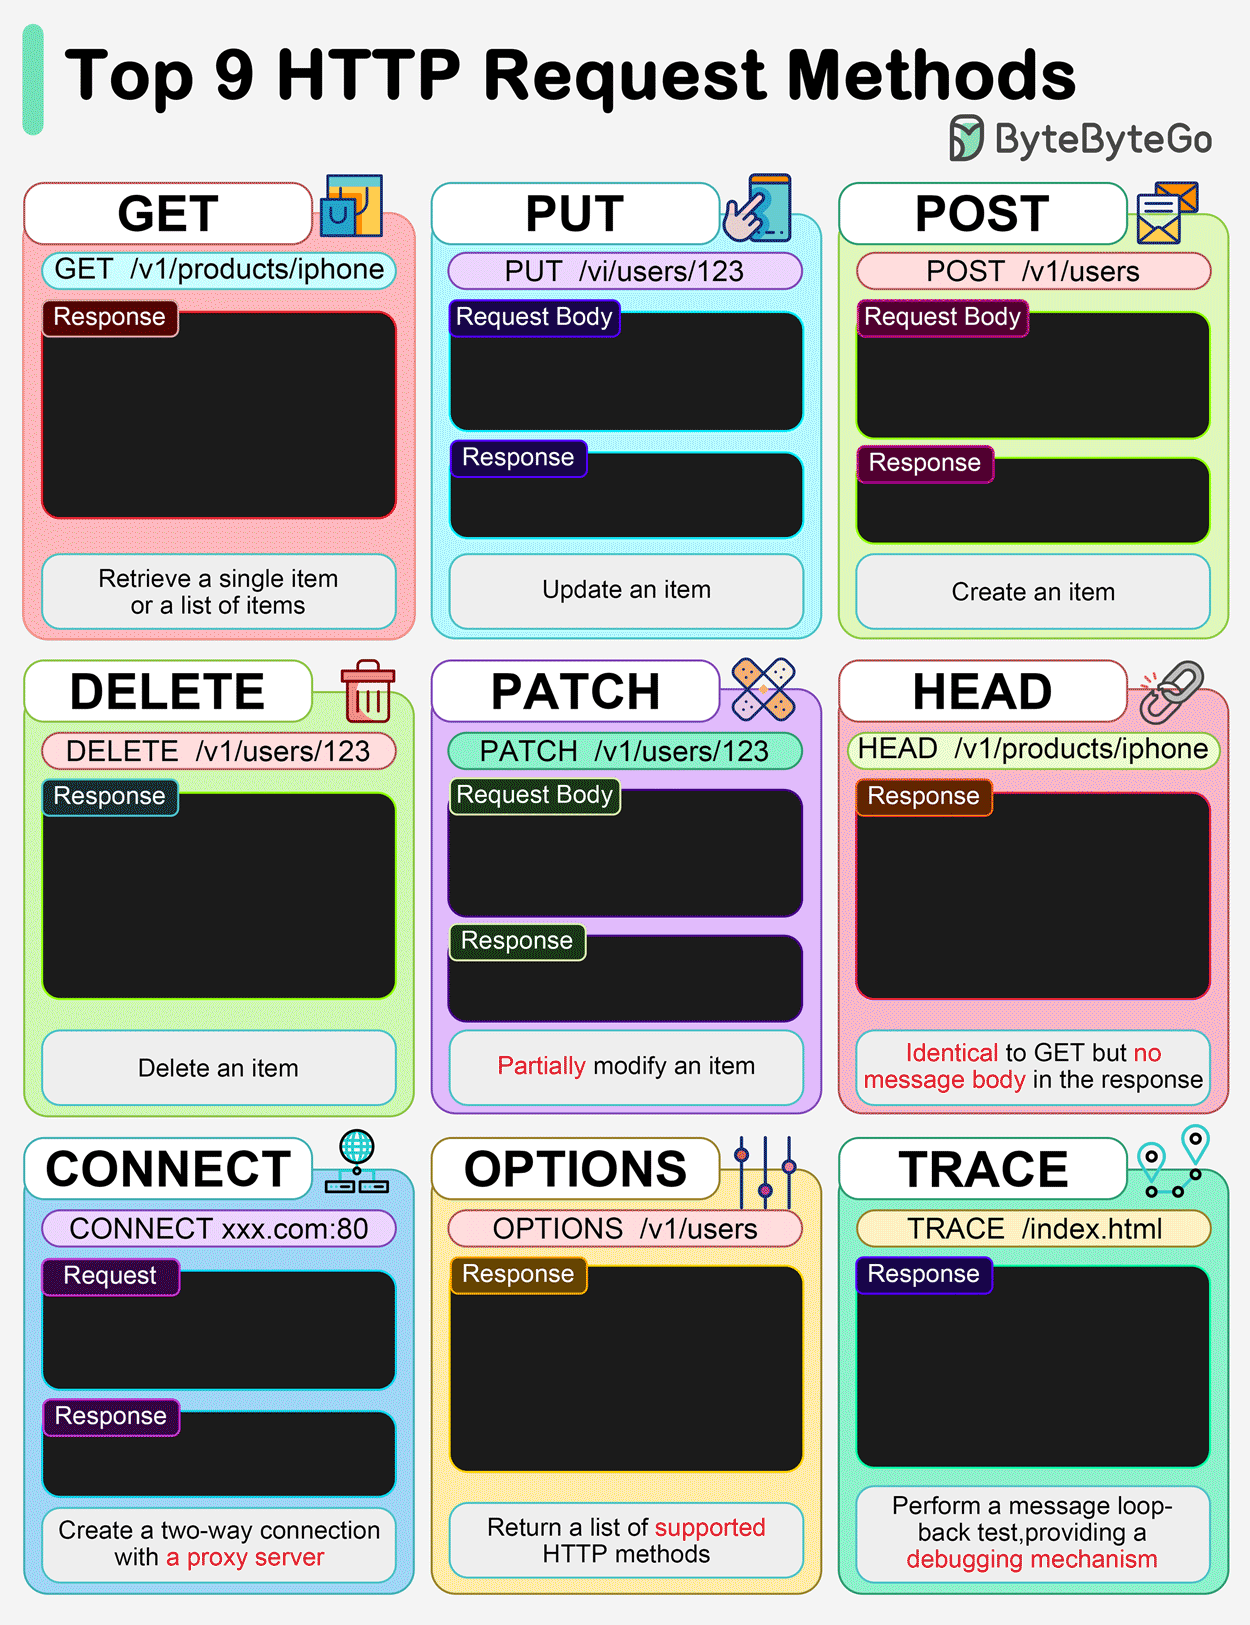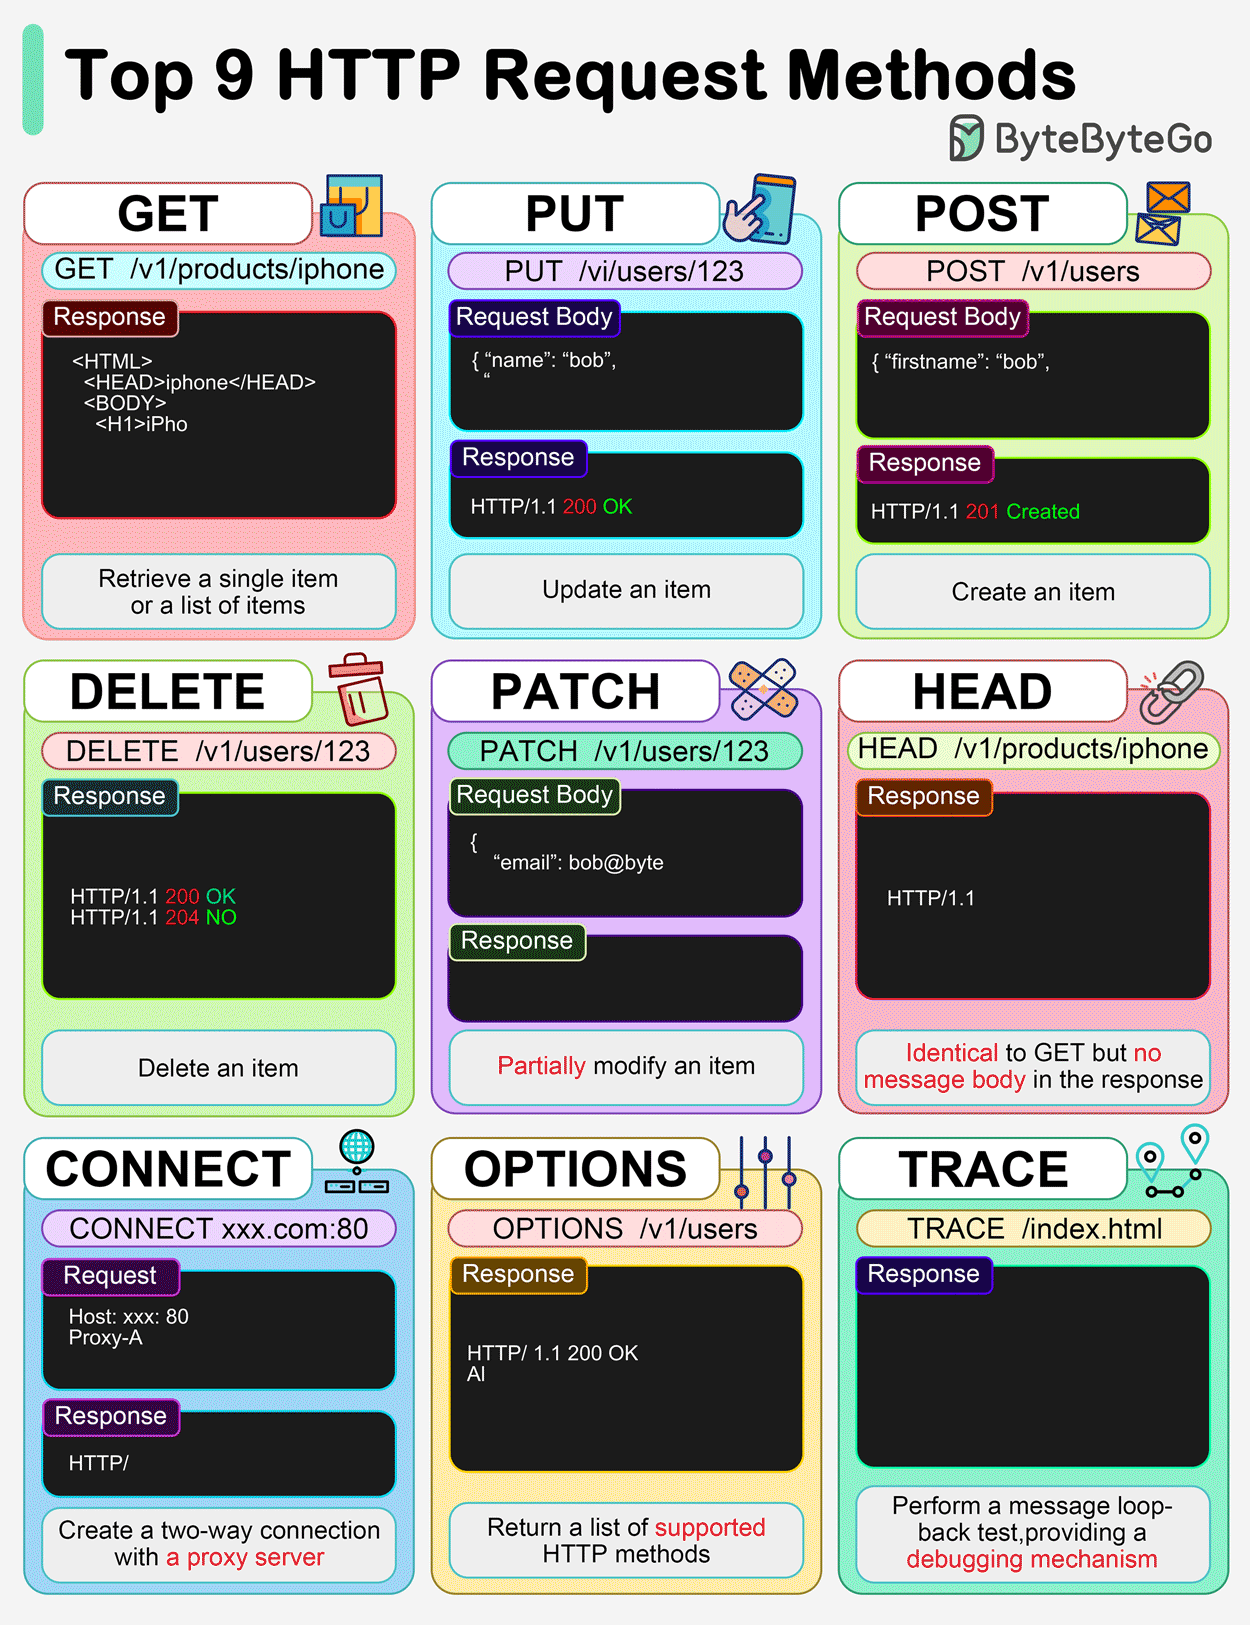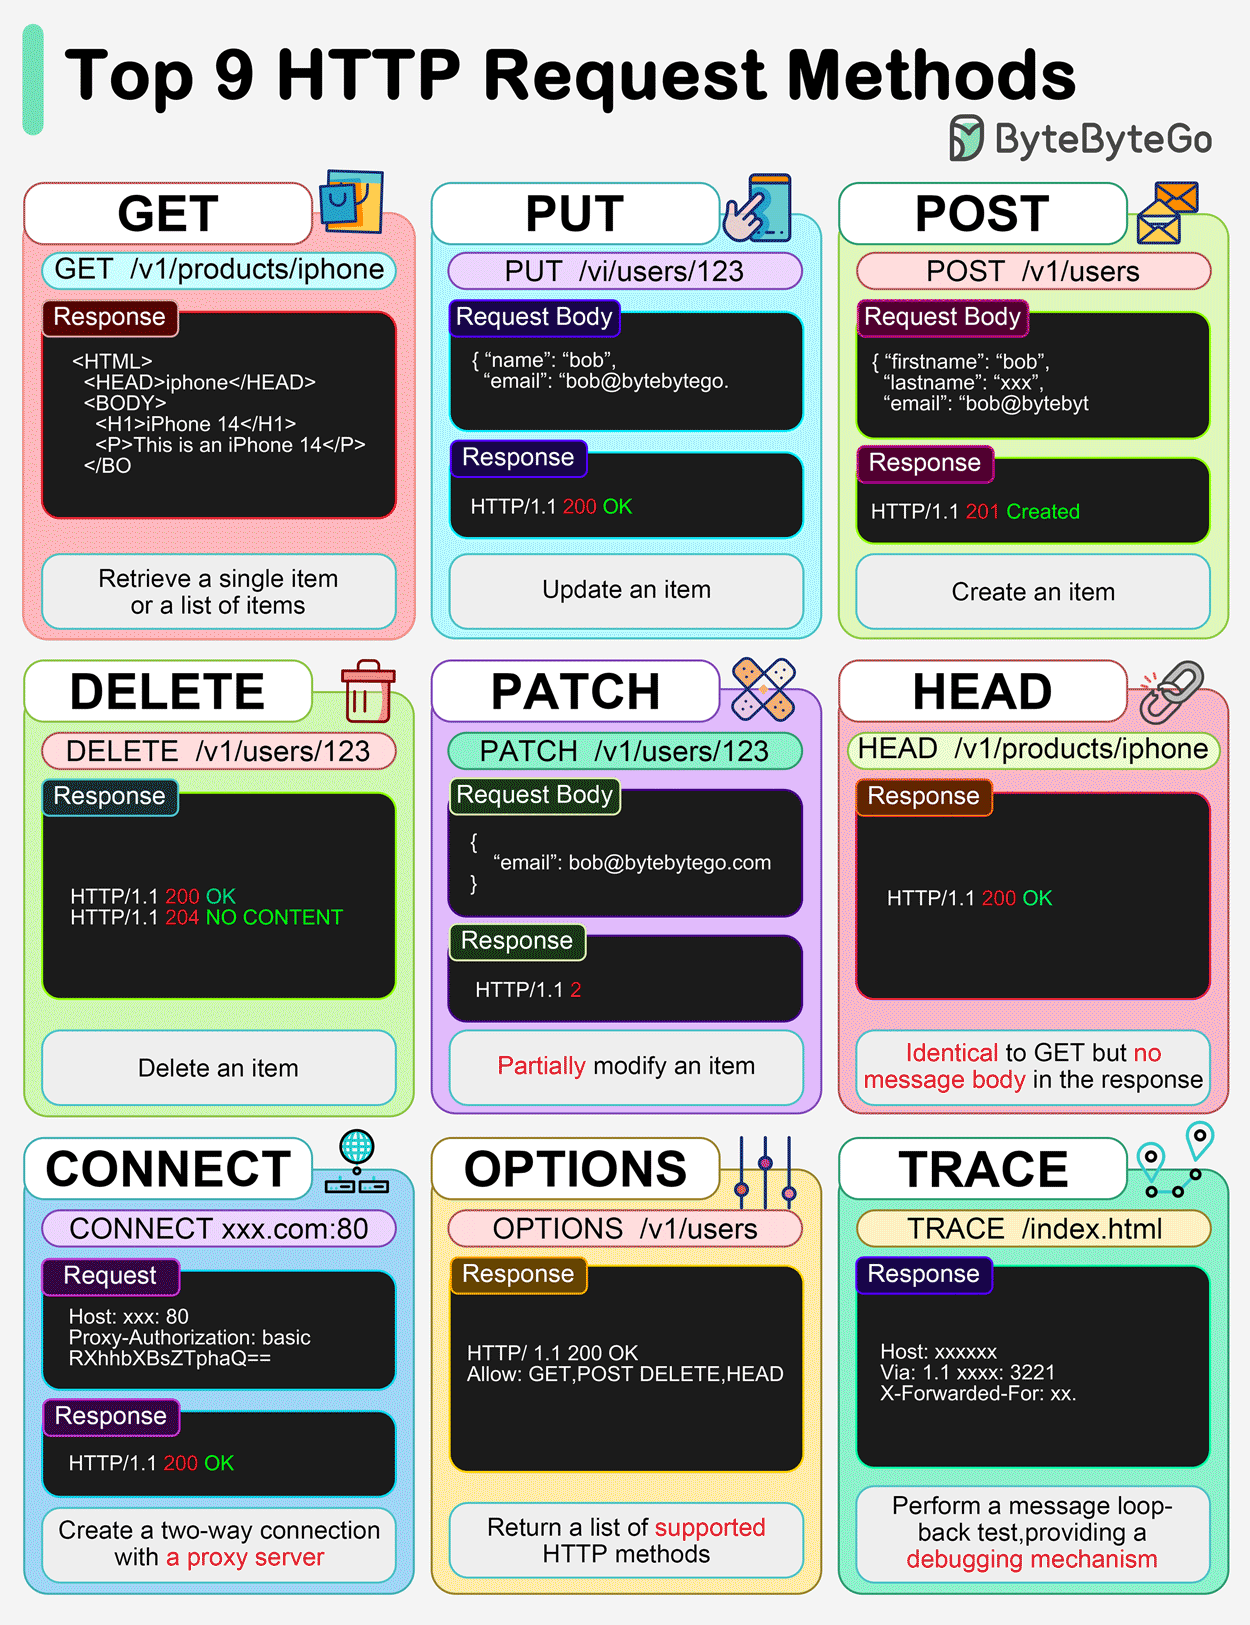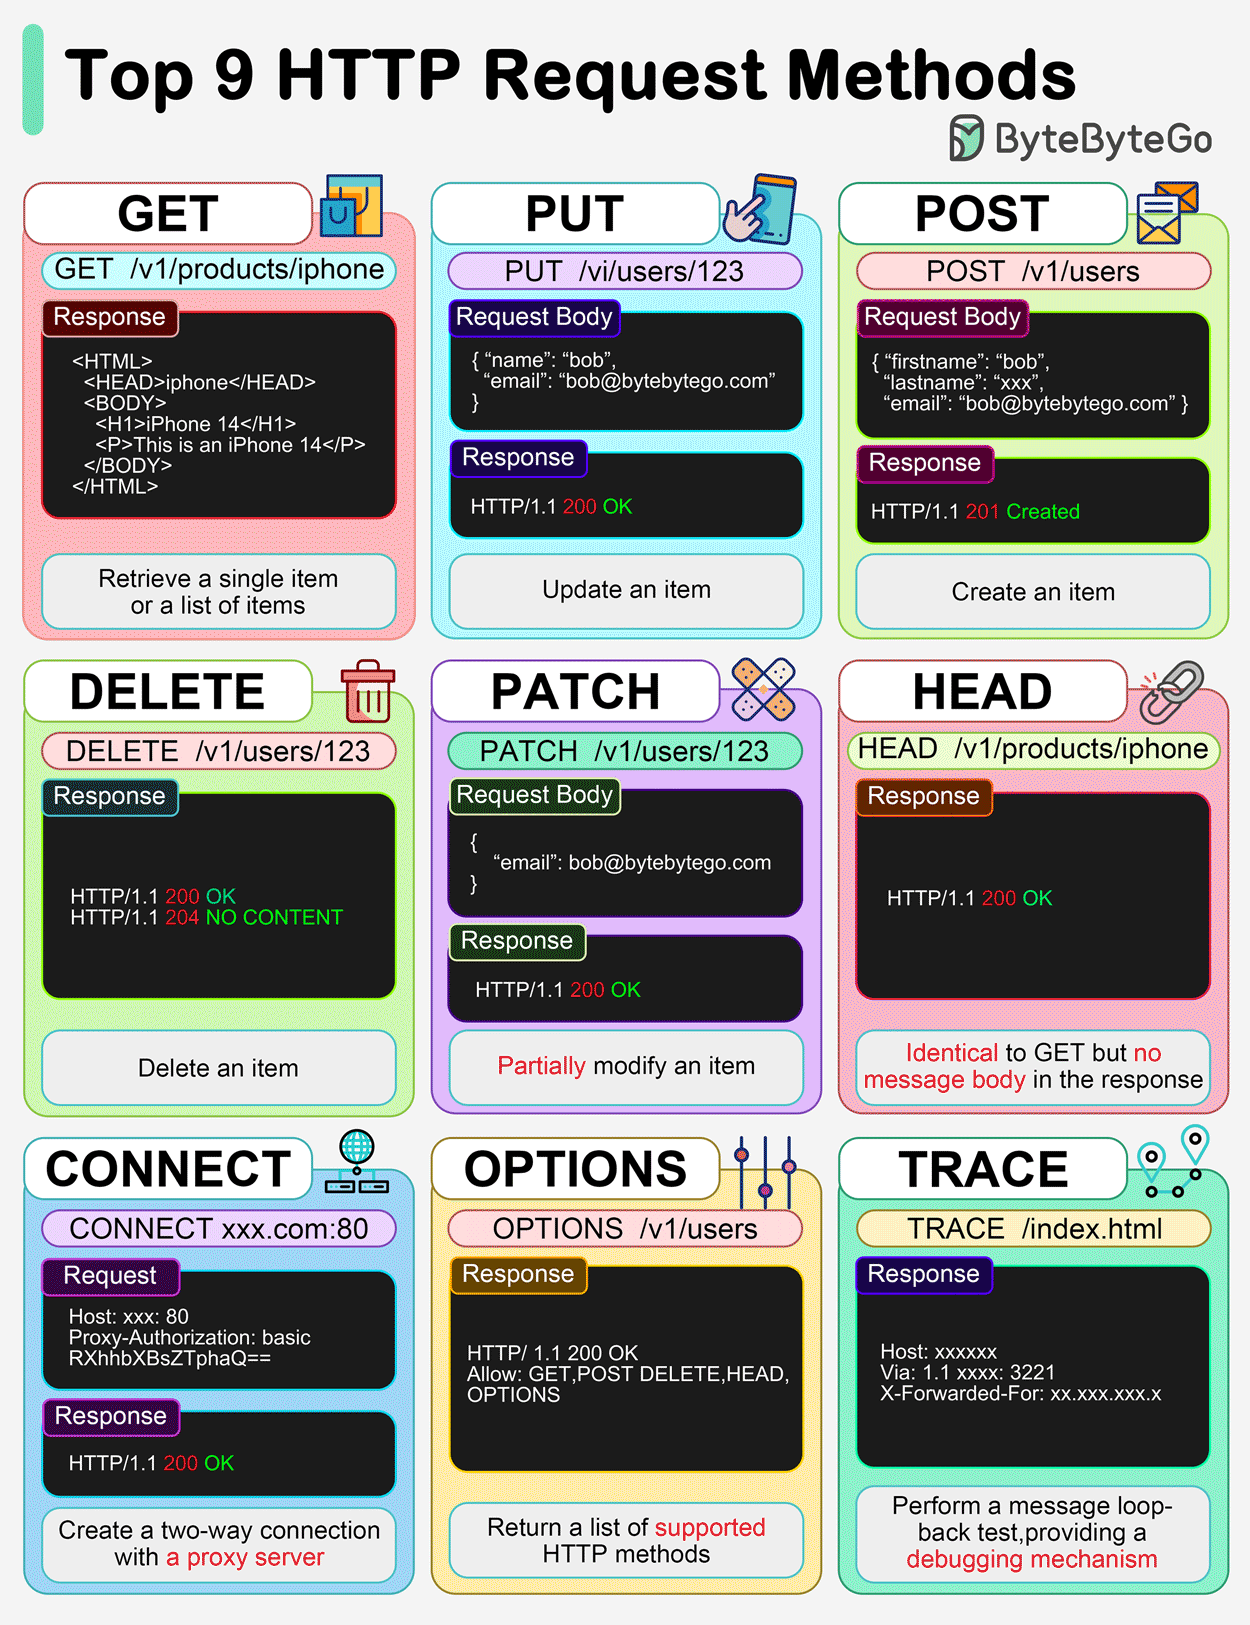
| Método | Uso habitual | Propiedad destacable |
|---|---|---|
GET |
Obtener un recurso | Seguro e idempotente |
POST |
Crear o procesar datos | Puede cambiar el estado |
PUT |
Reemplazar un recurso | Idempotente si se diseña correctamente |
PATCH |
Actualizar parcialmente | Solo modifica parte del recurso |
DELETE |
Eliminar un recurso | Idempotente en el sentido HTTP |
HEAD |
Consultar cabeceras | No devuelve el cuerpo |
OPTIONS |
Consultar opciones del recurso | Seguro e idempotente |
Conviene precisar dos términos:
- Un método seguro se define para no cambiar intencionadamente el estado
del servidor.
GETes seguro, aunque registrar una visita o actualizar una métrica técnica no convierte la operación en una modificación de negocio. - Un método idempotente produce, tras una o varias peticiones idénticas, el
mismo efecto previsto que una sola. La respuesta puede cambiar, por ejemplo,
porque incorpora una fecha distinta, pero el estado final esperado es el
mismo.
PUTyDELETEson idempotentes por semántica, aunque un diseño defectuoso puede incumplirla.
La idempotencia es importante cuando un cliente o un proxy debe reintentar una
operación por un corte de red. Reintentar un PUT con el mismo documento suele
ser razonable; repetir un POST puede crear dos recursos. Para operaciones de
creación que necesiten reintentos seguros, una API puede aceptar una clave de
idempotencia, pero esa decisión pertenece al contrato de la aplicación.
| Método | Ejemplo | Resultado habitual |
|---|---|---|
GET |
/productos/7 |
200 con la representación o 404. |
POST |
/productos con JSON |
201 y Location si crea un recurso. |
PUT |
/productos/7 con el recurso completo |
200 o 204; 404 si no existe, según el contrato. |
PATCH |
/productos/7 con {"precio":31} |
200 o 204 si se aplica el cambio parcial. |
DELETE |
/productos/7 |
204 si se elimina sin cuerpo. |
HEAD |
/manual.pdf |
Las cabeceras de un GET, sin cuerpo. |
OPTIONS |
/api/productos |
Allow y, si procede, cabeceras CORS. |
El cuerpo no está prohibido de forma general en todos los métodos, pero los
clientes y servidores no deben depender de un cuerpo en GET porque su
significado no está definido de forma interoperable para el uso habitual. Los
parámetros de consulta no son un mecanismo de autorización: nunca se deben
poner contraseñas o tokens en una URL, ya que pueden aparecer en historial,
logs, referers o herramientas de monitorización.
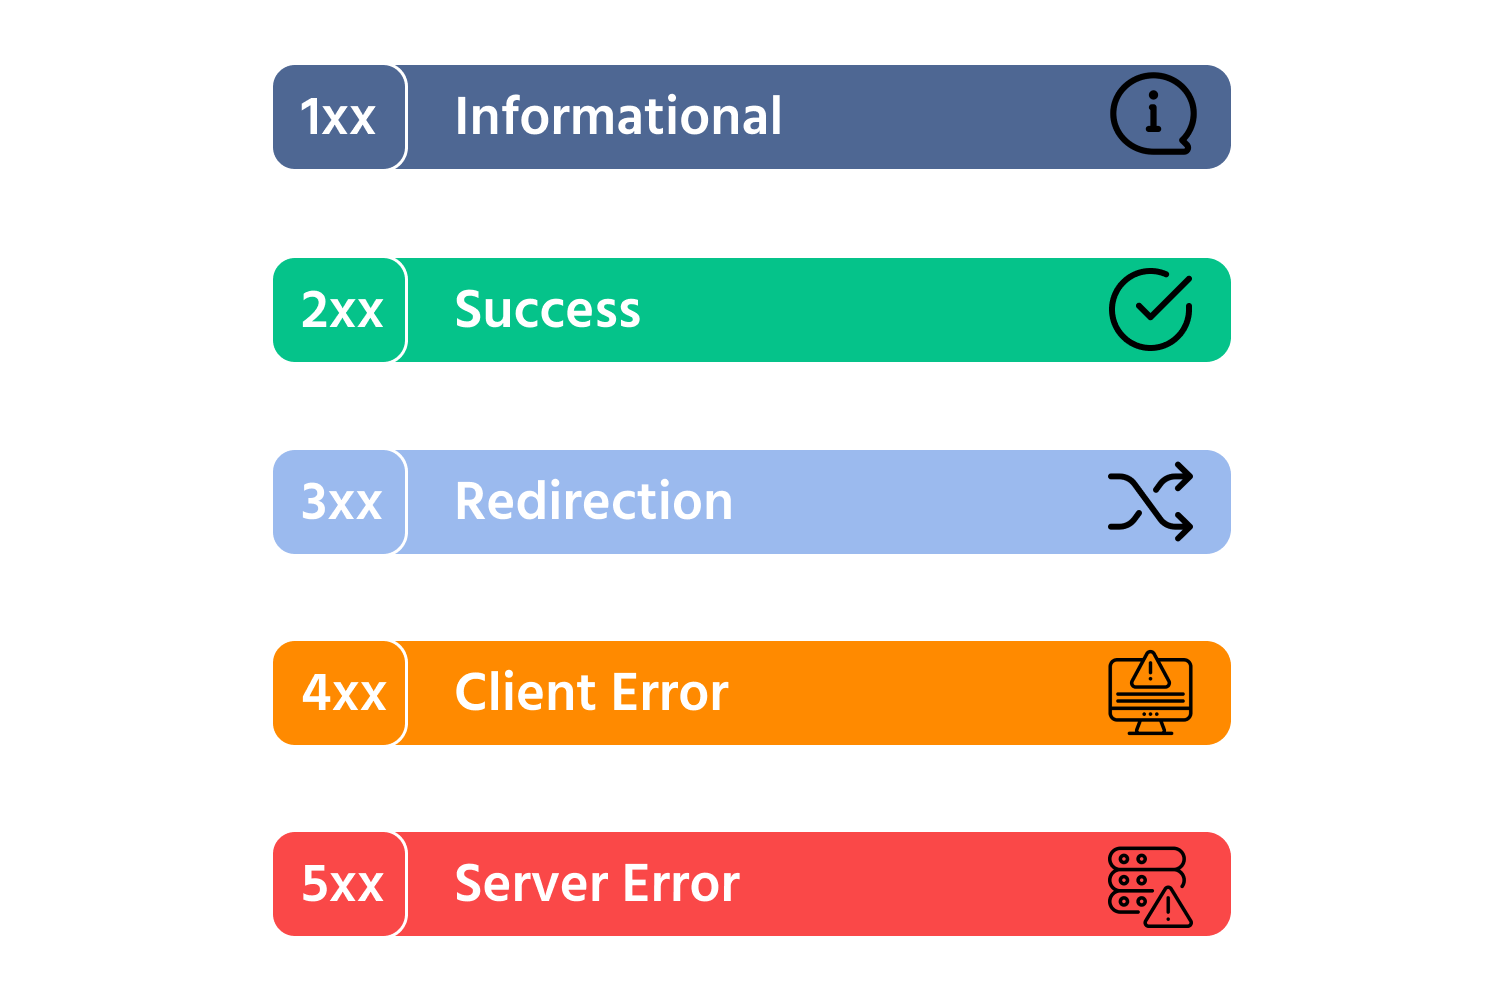
El código de estado resume el resultado:
2xx: operación correcta, por ejemplo200o201;3xx: redirección, por ejemplo301o304;4xx: problema de la petición o permisos, por ejemplo404o403;5xx: fallo del servidor o de un componente intermedio, por ejemplo502o503.
El código describe el resultado de esa petición, no una valoración global de la
aplicación. Un servidor puede responder 200 con una página de error propia y
un 404 puede generarlo el proxy o la aplicación. Por eso se debe leer el
código junto con la URL final, las cabeceras, el cuerpo y los registros.
| Familia y códigos | Interpretación y uso frecuente |
|---|---|
1xx |
Información provisional. 100 Continue permite continuar enviando un cuerpo; 101 cambia de protocolo. Son poco visibles en una navegación normal. |
200 OK |
La petición se ha atendido correctamente; es habitual en GET. |
201 Created |
Se ha creado un recurso. Conviene indicar su URI con Location. |
202 Accepted |
Se ha aceptado el trabajo, pero todavía no ha terminado. No significa que el resultado final sea correcto. |
204 No Content |
Operación correcta sin cuerpo, frecuente al borrar o actualizar. |
206 Partial Content |
Se devuelve un rango solicitado, por ejemplo en una descarga reanudable. |
301 / 308 |
Redirección permanente; 308 conserva el método y el cuerpo al seguirla. |
302 / 307 |
Redirección temporal; 307 conserva el método y el cuerpo. |
304 Not Modified |
El cliente puede utilizar su copia validada; no es un error. |
400 Bad Request |
El mensaje no puede interpretarse: sintaxis, JSON o parámetros inválidos. |
401 Unauthorized |
Falta autenticación válida. Puede incluir WWW-Authenticate. |
403 Forbidden |
La identidad se conoce o no se permite el acceso, aunque se autentique. |
404 Not Found |
No se encuentra la ruta o el recurso; hay que comprobar proxy y aplicación. |
405 Method Not Allowed |
La ruta existe, pero no acepta ese método; puede incluir Allow. |
409 Conflict |
La operación entra en conflicto con el estado actual, por ejemplo un duplicado. |
413 Payload Too Large |
El cuerpo supera el límite configurado. |
415 Unsupported Media Type |
El servidor no admite el formato indicado por Content-Type. |
429 Too Many Requests |
Se ha superado un límite de frecuencia; puede incluir Retry-After. |
500 Internal Server Error |
Fallo no controlado en el servidor o la aplicación. |
502 Bad Gateway |
Un proxy recibió una respuesta inválida o no pudo obtener una respuesta válida del backend. |
503 Service Unavailable |
Servicio temporalmente no disponible por mantenimiento, saturación o dependencia caída. |
504 Gateway Timeout |
El intermediario agotó el tiempo esperando al backend. |
Hay dos distinciones especialmente útiles al diagnosticar:
401no significa «permisos insuficientes», sino que falta una autenticación válida o no se ha presentado correctamente.403indica que la autenticación no permite realizar esa operación.502y504suelen señalar una comunicación problemática entre proxy y backend;500indica que un componente del servidor falló al procesar la petición;503suele expresar indisponibilidad temporal. Son pistas, no un diagnóstico definitivo.
Comprobación desde terminal
curl -i http://localhost:8080/ muestra cabeceras y cuerpo. curl -I
solicita solo las cabeceras. Si hay Nginx delante de Tomcat, un 502 Bad
Gateway suele indicar que el proxy no puede comunicarse con el backend;
no significa necesariamente que la ruta del navegador sea incorrecta.
curl -i http://localhost:8080/
curl -I https://example.org/
curl -v https://example.org/ -o /dev/null
curl -L -i http://example.org/
curl -X POST https://api.example.org/productos \
  -H 'Content-Type: application/json' \
  -d '{"nombre":"Teclado","precio":29.90}'
-v muestra detalles de la conexión y de TLS; -L sigue redirecciones; -I
realiza una petición HEAD; -i incluye las cabeceras en la salida. En una
prueba real conviene revisar también el código de salida de curl y guardar la
hora, la URL, el método, el código, la latencia y el tamaño de la respuesta.
No se debe utilizar -k como solución permanente: desactiva la validación del
certificado y solo puede tener sentido en una prueba local controlada.
Para comprobar un sitio virtual que todavía no tiene DNS público, --resolve
permite asociar temporalmente un nombre y un puerto con una IP concreta:
Así se conserva el nombre usado por Host y por TLS, algo que no se comprueba
si se sustituye directamente el dominio por 127.0.0.1.
5. HTTP seguro: HTTPS y TLS
HTTP sin cifrar permite que alguien situado en el camino lea o modifique la comunicación. HTTPS combina HTTP con TLS y proporciona:
- confidencialidad, porque cifra los datos;
- integridad, porque detecta modificaciones;
- autenticación del servidor, mediante su certificado.
Durante el establecimiento TLS, el cliente valida el certificado, comprueba el nombre del servidor y negocia una clave de sesión. Un certificado autofirmado es útil en desarrollo, pero provoca avisos porque no está respaldado por una autoridad de certificación confiable. En producción se debe usar un certificado válido y renovarlo antes de que caduque.
5.1. Qué protege TLS
HTTPS es HTTP transportado dentro de TLS. TLS no cambia los métodos, las cabeceras ni los códigos HTTP; protege el canal por el que circulan esos datos. Sus objetivos principales son:
- confidencialidad: una persona que intercepte el tráfico no debería poder leer el contenido HTTP;
- integridad: una modificación de los datos debe provocar un error, no una respuesta aceptada silenciosamente;
- autenticación del servidor: el cliente verifica que la clave pública está asociada al nombre solicitado y a una cadena de confianza.
TLS no autentica automáticamente a la persona usuaria de la aplicación, no garantiza que la aplicación sea honesta y no oculta todos los metadatos de la comunicación: la dirección IP, el momento y el volumen de tráfico pueden seguir siendo observables. La aplicación necesita sus propios mecanismos de autenticación y autorización.
5.2. Establecimiento de una conexión HTTPS
De forma simplificada, el establecimiento de TLS sigue estos pasos:
- El cliente indica las versiones y algoritmos que admite y el nombre del servidor al que quiere conectarse.
- El servidor selecciona parámetros compatibles y envía su certificado o la cadena necesaria para validarlo.
- El cliente comprueba el nombre del certificado, su periodo de validez, la cadena de firmas y la confianza en la autoridad de certificación. También puede comprobar su revocación según la política del sistema.
- Ambos extremos realizan un intercambio de claves que permite obtener una clave de sesión sin enviarla en claro.
- A partir de ese momento, los mensajes HTTP viajan cifrados y protegidos frente a modificaciones.
En TLS moderno el certificado sirve principalmente para autenticar la identidad del servidor y su clave pública; no debe explicarse como si el servidor cifrara todo el tráfico con una clave pública de forma directa. El contenido se protege con claves de sesión eficientes.
sequenceDiagram
  participant C as Cliente
  participant S as Servidor HTTPS
  C->>S: ClientHello y nombre del servidor
  S-->>C: Parametros TLS y certificado
  C->>C: Valida nombre y cadena de confianza
  C->>S: Intercambio de claves
  S-->>C: Canal TLS establecido
  C->>S: Peticion HTTP cifrada
  S-->>C: Respuesta HTTP cifrada
5.3. Certificados y entornos
Un certificado vincula un nombre, como catalogo.example, con una clave
pública y una identidad validada por una autoridad de certificación. El
navegador comprueba que el nombre aparece en la extensión Subject Alternative
Name, no solo que el certificado exista. Un certificado autofirmado puede ser
apropiado para un laboratorio si se instala explícitamente su autoridad de
confianza; no es una solución de producción por el mero hecho de que la
conexión aparezca como cifrada.
En producción conviene:
- usar TLS 1.2 o TLS 1.3 conforme a la política de seguridad y desactivar SSL y versiones antiguas de TLS;
- automatizar la renovación y comprobarla antes de la fecha de caducidad;
- configurar correctamente los nombres alternativos, la cadena intermedia y la clave privada;
- redirigir HTTP a HTTPS cuando el servicio lo requiera y aplicar HSTS después de haber verificado que todos los subdominios funcionan por HTTPS;
- no registrar claves privadas, tokens ni el contenido sensible de las peticiones.
HSTS indica al navegador que debe usar HTTPS durante un periodo, pero no sustituye al certificado ni corrige una primera conexión insegura si el dominio no estaba ya en una lista de precarga. Por eso la redirección, el certificado y la política HSTS deben probarse como un conjunto.
5.4. Interpretar un fallo TLS
Un mensaje como «certificado no válido» puede deberse a un nombre que no
coincide, a una cadena incompleta, a una fecha incorrecta, a una autoridad no
confiable o a un reloj del sistema desajustado. Es distinto de un 404: en un
fallo TLS normalmente no se llega a intercambiar una respuesta HTTP válida.
Este comando permite inspeccionar la cadena durante una práctica controlada, pero no reemplaza una configuración segura ni una prueba desde el navegador.
6. Buenas prácticas
- Usar HTTPS fuera de entornos de prueba: no envíes credenciales ni cookies de sesión por HTTP sin cifrar.
- Leer el código y las cabeceras juntas: un
200no garantiza que la respuesta sea la esperada ni que la aplicación esté sana. - Distinguir puertos internos y publicados: un backend puede escuchar en
8080dentro de una red y no estar expuesto al host. - Registrar sin secretos: los logs ayudan a depurar, pero no deben contener contraseñas, tokens ni datos personales innecesarios.
- Usar el método que expresa la operación: separa lectura, creación, actualización y borrado, y documenta si una operación puede reintentarse.
- Validar en el servidor: la validación del navegador mejora la experiencia, pero no sustituye a la validación de formato, autenticación y autorización en el backend.
- Definir límites y tiempos: configura tamaños máximos, timeouts, límites de frecuencia y mensajes de error que no revelen trazas ni secretos.
- Proteger las cookies de sesión: usa
Secure,HttpOnlyy una políticaSameSiteadecuada al flujo, además de renovar o invalidar la sesión cuando corresponda. - Correlacionar evidencias: conserva método, ruta, código, latencia y un identificador de petición; evita guardar cuerpos sensibles por defecto.
- Comprobar las redirecciones y certificados: revisa la URL final, la cadena de confianza y la fecha de renovación, no solo que el navegador muestre un candado.
7. Errores frecuentes
| Error frecuente | Por qué ocurre | Cómo evitarlo |
|---|---|---|
| Confundir URL con dirección IP | Se olvida DNS y el puerto | Divide la URL en esquema, host, puerto y ruta |
Interpretar 502 como un error del navegador |
El fallo suele estar entre proxy y backend | Revisa red, nombre del servicio y logs |
Pensar que EXPOSE publica un puerto |
Se confunde documentación con mapeo | Comprueba el mapeo del host y del contenedor |
| Usar certificado autofirmado en producción | Funciona en local y parece suficiente | Usa una CA confiable y un proceso de renovación |
Confundir 401 con 403 |
Se mezclan autenticación y autorización | 401 pide identidad válida; 403 rechaza la operación permitida |
Creer que 200 demuestra que la aplicación está bien |
Solo se observa la familia de estado | Comprueba contenido, cabeceras, logs y una prueba funcional |
Usar GET para borrar o cambiar datos |
Se confía en enlaces o formularios rápidos | Usa el método adecuado y protege la operación |
Reintentar cualquier POST automáticamente |
Se ignora que puede crear duplicados | Diseña idempotencia o usa una clave de idempotencia |
| Poner tokens o contraseñas en la URL | Los parámetros parecen fáciles de probar | Envía credenciales por cabeceras o cuerpo protegido y revisa logs |
| Pensar que CORS autentica la API | Se confunde política del navegador con control de acceso | Autentica y autoriza en el servidor; configura CORS con orígenes concretos |
Desactivar la validación con curl -k |
Se quiere ocultar un fallo de certificado | Corrige nombre, cadena, fecha o confianza; reserva -k para laboratorios |
Exponer trazas en respuestas 5xx |
Se reutiliza el error de desarrollo | Muestra un mensaje genérico y registra el detalle de forma controlada |
8. Resumen y conclusión
- HTTP organiza la comunicación en peticiones y respuestas.
- DNS, puertos, TCP, QUIC y, cuando procede, TLS permiten llegar al servidor y transportar los mensajes.
- Una URL distingue esquema, host, puerto, ruta, consulta y fragmento; el fragmento lo procesa el cliente y no se envía al servidor.
- Las peticiones y respuestas tienen una estructura formada por línea inicial, cabeceras, línea vacía y cuerpo opcional; en HTTP/2 y HTTP/3 esa semántica se transporta mediante tramas binarias.
- Métodos, cabeceras, representaciones, cookies y códigos aportan semántica y permiten diagnosticar el recorrido.
- Los códigos
4xxy5xxson pistas que deben contrastarse con proxy, aplicación, datos y registros; no basta con memorizar sus nombres. - HTTPS protege confidencialidad e integridad y autentica el servidor mediante TLS y certificados, pero no sustituye la autenticación de la aplicación.
Idea clave
Para desplegar y diagnosticar una aplicación web, sigue el mensaje desde el nombre DNS hasta la respuesta: destino, conexión, TLS, servidor web, backend, datos y código recibido. Cada etapa tiene un contrato, unos riesgos y unas evidencias distintas. Comprender ese recorrido permite pasar de «sale un error» a una hipótesis técnica que se puede comprobar.
9. Para seguir practicando
- Consulta el tema de HTTP y HTTPS del repositorio.
- Usa
curlpara comprobar el acceso a Tomcat detrás de Nginx. - Abre las herramientas de desarrollo del navegador, filtra la pestaña Red y compara una petición de documento, una imagen, una hoja CSS y una llamada JSON. Anota método, URL, código, tipo MIME, caché y tiempo de respuesta.
- Repite una petición con
GET,HEADyOPTIONSy explica qué cambia en la respuesta. Después provoca de forma controlada un404y un405, sin utilizar datos reales. - Construye una petición
POSTcontra un servidor local y comprueba la diferencia entre400,401,403,404,415y500mediante casos documentados. - Revisa la introducción a HTTP y HTTPS de José Juan Sánchez.
Bibliografía y fuentes
- RFC 9110: HTTP Semantics.
- MDN: HTTP.
- Material propio: protocolo HTTP y HTTPS.
- José Juan Sánchez: introducción a HTTP.
- Normativa del módulo 0614.
Presentación
Consulta la presentación DAW-U3.2 - Comunicación web: HTTP y HTTPS, que desarrolla el ciclo petición-respuesta, los mensajes, los métodos, los códigos de estado y TLS.