3.1.-Arquitecturas web
3.1. Arquitecturas web
Idea principal
Una arquitectura web describe qué componentes participan en una aplicación, qué responsabilidad tiene cada uno, cómo se comunican y cómo se distribuyen. En una web clásica, la separación en presentación, lógica de negocio y datos permite entender el recorrido de una petición y mantener el sistema sin mezclar decisiones de interfaz, reglas y persistencia.
Una arquitectura no es solo un dibujo de servidores. Es un modelo que conecta las necesidades de la aplicación con sus componentes software, sus datos, sus comunicaciones y su forma de despliegue. Esta distinción es importante: una aplicación puede tener tres capas lógicas aunque, durante el desarrollo, todas se ejecuten en un único equipo.
En este apunte se profundiza especialmente en la arquitectura de tres capas, porque es un modelo habitual para las webs clásicas que se van a desplegar en este módulo. Se parte del modelo cliente-servidor, se compara con el de dos capas, se relaciona con un monolito y con el patrón MVC, y después se contrasta con servicios, microservicios y serverless. El objetivo es poder elegir y justificar una solución, no memorizar una lista de nombres.
La normativa del módulo sitúa este contenido en el RA1 y, de forma directa, en el criterio CE a:
| Código | Descripción |
|---|---|
| RA1 | Implanta arquitecturas web analizando y aplicando criterios de funcionalidad. |
| CE a | Se han analizado aspectos generales de arquitecturas web, sus características, ventajas e inconvenientes. |
Qué deberías saber al terminar
Al acabar este tema deberías poder:
- explicar qué función cumplen el cliente, el servidor web, la aplicación y la base de datos;
- distinguir dos capas, tres capas, niveles lógicos y niveles físicos;
- describir con detalle las responsabilidades y límites de las tres capas de una web clásica;
- diferenciar un monolito organizado por capas de una arquitectura de microservicios;
- representar el recorrido de una petición y justificar una decisión arquitectónica con criterios de funcionalidad.
Mapa del tema
Seguiremos esta secuencia:
- modelo cliente-servidor y responsabilidades;
- arquitecturas de dos y tres capas, con especial atención a la web clásica;
- relación entre capas, monolito y patrón MVC;
- arquitecturas distribuidas y criterios para tomar una decisión.
1. Del problema a los componentes: el modelo cliente-servidor
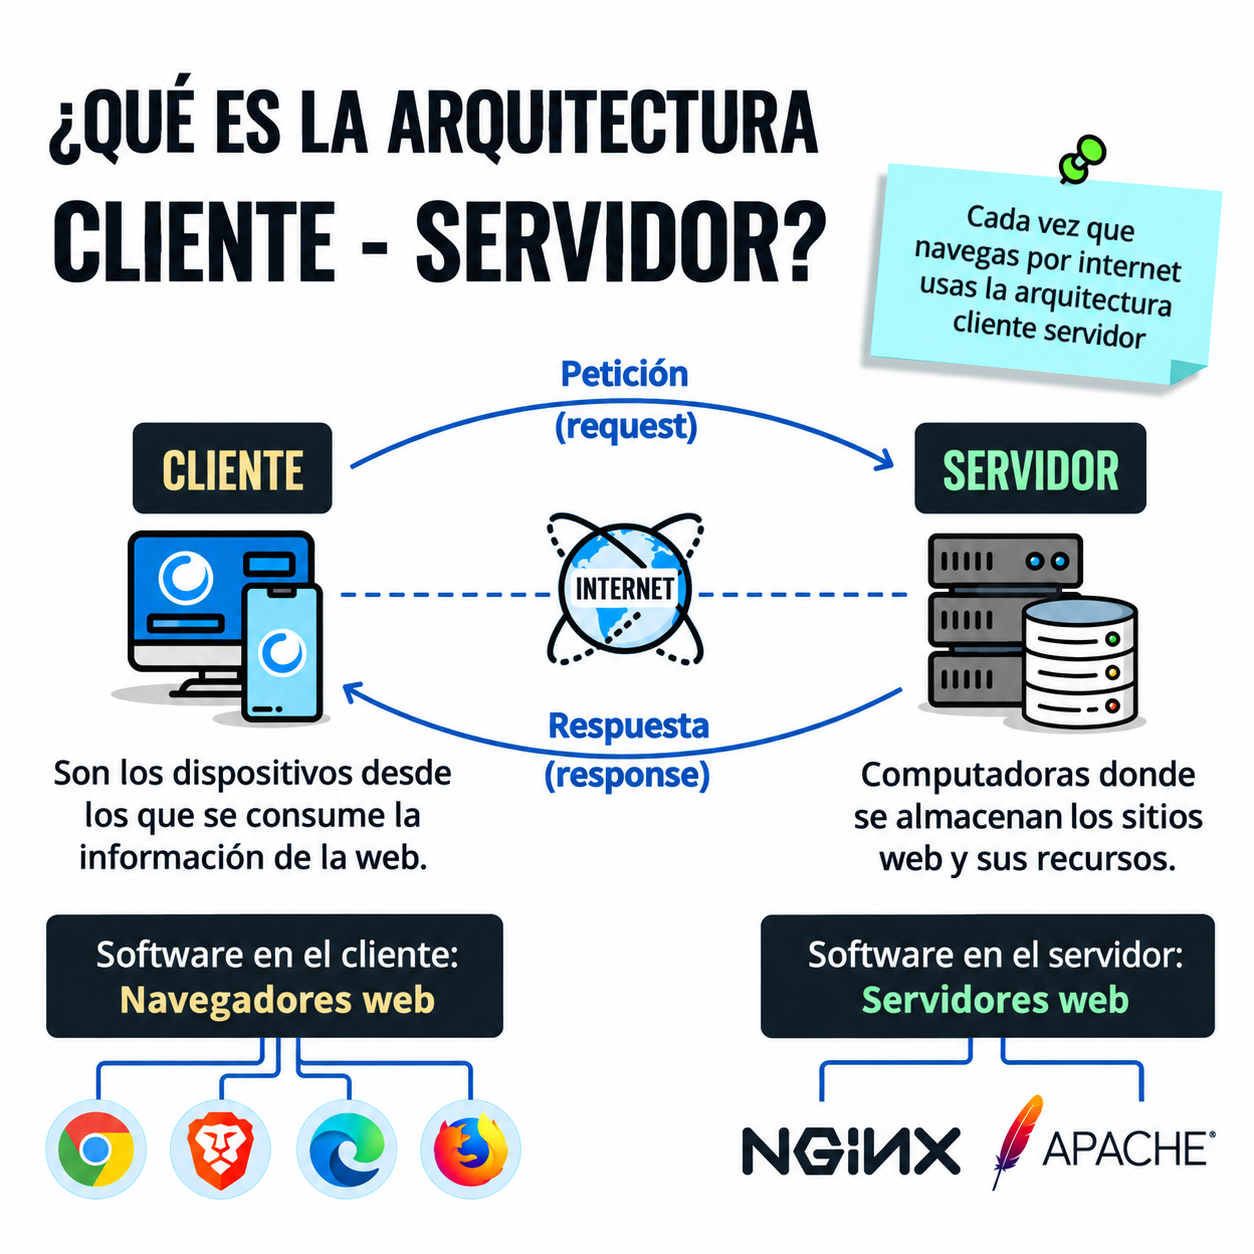
En una aplicación web, una persona usuaria utiliza normalmente un navegador para solicitar un recurso o una operación. El navegador es el cliente. Un servidor recibe la petición, la procesa con los componentes necesarios y envía una respuesta. La red y un protocolo, habitualmente HTTP o HTTPS, permiten el intercambio.
Arquitectura web
Es la organización de componentes software, infraestructura, datos y comunicaciones que permite que una aplicación web atienda peticiones y gestione información.
El modelo cliente-servidor es una relación de roles, no necesariamente una relación de máquinas. Un mismo equipo puede ejecutar un navegador, un servidor web y una base de datos durante una práctica. En producción, esos roles pueden estar separados para mejorar el aislamiento, el mantenimiento o la capacidad de crecimiento.
| Elemento | Responsabilidad habitual | Ejemplo |
|---|---|---|
| Cliente | Presentar la interfaz, recoger acciones y enviar peticiones | Navegador web |
| Servidor web | Recibir HTTP, servir recursos estáticos y enrutar peticiones | Nginx o Apache HTTP Server |
| Aplicación | Ejecutar casos de uso, validar reglas y preparar respuestas | PHP-FPM, Tomcat, Node.js o una aplicación Java |
| Datos | Persistir y consultar información | MariaDB, PostgreSQL o Redis |
| Red y protocolos | Transportar mensajes y controlar cómo se intercambian | TCP, TLS y HTTP/HTTPS |
1.1. Recorrido básico de una petición
Imaginemos que una persona visita https://catalogo.example/productos/42.
El navegador resuelve el nombre mediante DNS, establece la comunicación segura y
envía una petición HTTP. El servidor web puede devolver directamente una imagen
o una hoja de estilos. Si la petición solicita datos o una operación, la enruta
a la aplicación. Esta puede consultar la base de datos y construir una
respuesta HTML o JSON.
flowchart LR
  C["Cliente<br/>navegador"] -->|"HTTPS"| W["Servidor web<br/>Nginx o Apache"]
  W -->|"Contenido estatico"| C
  W -->|"Peticion dinamica"| A["Aplicacion web<br/>logica y presentacion"]
  A -->|"Consulta o actualizacion"| D["Datos<br/>base de datos"]
  D -->|"Resultado"| A
  A -->|"Respuesta HTML o JSON"| W
La aplicación no tiene por qué participar en todas las peticiones. Servir un fichero CSS desde Nginx es distinto de ejecutar una consulta de productos. Esta diferencia afecta al rendimiento, a la seguridad y al diagnóstico de errores.
1.2. Ventajas y límites del modelo cliente-servidor
El modelo se ha impuesto porque centraliza buena parte de la lógica y de los datos, pero no elimina los problemas de una aplicación distribuida.
| Aspecto | Ventaja | Límite o riesgo |
|---|---|---|
| Mantenimiento | Una actualización del servidor puede llegar a todas las personas usuarias | Hay que controlar versiones, compatibilidad y disponibilidad |
| Portabilidad | El navegador evita instalar un programa específico en cada cliente | Dependemos del navegador, la red y las capacidades del dispositivo |
| Escalabilidad | Es posible replicar servidores o aumentar sus recursos | Más instancias exigen sesiones, datos y configuración coherentes |
| Control de datos | Las reglas y la persistencia pueden mantenerse en el servidor | El servidor puede convertirse en cuello de botella o punto único de fallo |
| Seguridad | Los datos sensibles no tienen que enviarse al cliente | Hay que autenticar, autorizar, cifrar y validar siempre en el servidor |
Entre las medidas habituales para mitigar estos límites están los balanceadores de carga, que reparten peticiones entre varios servidores; las cachés, que guardan temporalmente respuestas para no recalcularlas; las redes de distribución de contenido, que acercan archivos estáticos a las personas usuarias; la replicación, que mantiene varias copias de un servicio o dato; y los mecanismos de alta disponibilidad, que reducen el tiempo en que un servicio permanece fuera de funcionamiento. Virtualizar o contenerizar facilita repetir un entorno, pero por sí solo no proporciona redundancia ni convierte la aplicación en distribuida.
1.3. De la web estática a las aplicaciones distribuidas
La evolución de la web ayuda a entender por qué aparecen nuevas separaciones. No debe interpretarse como una sucesión de versiones cerradas: una web actual puede seguir sirviendo ficheros estáticos y una web dinámica puede utilizar un monolito sencillo.
Antes de comparar estas tendencias, aclaremos tres términos:
- Una API es una interfaz que permite que un programa solicite funciones o datos a otro programa siguiendo unas reglas.
- Una SPA (Single Page Application) es una aplicación que carga una página inicial y actualiza gran parte de la interfaz desde el navegador, normalmente consumiendo una API.
- El backend es la parte de la aplicación que se ejecuta en el servidor y contiene la lógica y el acceso a los datos.
| Tendencia | Qué ocurre | Consecuencia arquitectónica |
|---|---|---|
| Web estática | El servidor entrega ficheros HTML, CSS, JavaScript o imágenes | Predominan el servidor web y el almacenamiento de recursos |
| Web dinámica | El servidor ejecuta código y consulta datos para cada petición | Aparecen una aplicación y una base de datos detrás del servidor web |
| Cliente enriquecido o SPA | El navegador ejecuta más presentación y consume una API | Se separan con claridad la interfaz cliente y el backend |
| Servicios distribuidos | Varias capacidades colaboran mediante APIs o eventos | Aumentan el escalado selectivo y también la complejidad de red |
La tendencia no obliga a adoptar el último modelo. Una aplicación con HTML generado en el servidor puede ser más sencilla de mantener que una SPA, y un monolito por capas puede responder mejor a los requisitos que muchos servicios.
2. Arquitecturas de dos y tres capas
Cuando hablamos de capas, describimos responsabilidades y dependencias lógicas. Cuando hablamos de niveles físicos o tiers, describimos dónde se ejecutan esas responsabilidades: en qué proceso, contenedor, máquina o servicio. No deben confundirse ambos conceptos.
Por ejemplo, una aplicación puede tener presentación, negocio y datos como tres capas lógicas, pero ejecutarlas todas en un mismo proceso durante una práctica. También puede desplegar esas capas en varios contenedores. La separación lógica ayuda a organizar el código; la separación física afecta al aislamiento, la escalabilidad y la operación.
2.1. Arquitectura de dos capas
En una arquitectura de dos capas se distinguen dos participantes principales:
- Cliente: presenta la interfaz y contiene parte de la lógica.
- Servidor: atiende peticiones y puede incluir la lógica de negocio y los datos.
En los sistemas tradicionales de escritorio era frecuente que un cliente «grueso» se conectara directamente a una base de datos. El cliente podía contener validaciones y consultas SQL. En una web, en cambio, lo habitual es que el navegador sea un cliente más ligero y que el servidor intermedio proteja la base de datos.
| Variante | Dónde está la lógica | Riesgo principal |
|---|---|---|
| Cliente grueso y servidor de datos | Parte importante en el cliente; el servidor persiste | Exposición de credenciales, reglas duplicadas y dificultad para actualizar clientes |
| Cliente web y servidor de aplicación con datos integrados | El servidor concentra aplicación y datos | El servidor reúne demasiadas responsabilidades y escala de forma menos selectiva |
Ventajas de dos capas: hay pocos componentes, el flujo es fácil de montar y las llamadas pueden ser rápidas en un entorno pequeño. Inconvenientes: se mezclan responsabilidades, el cliente puede quedar acoplado a la base de datos y resulta más difícil cambiar la persistencia o escalar solo una parte.
No conectes el navegador directamente con la base de datos
En una aplicación web normal, el navegador no debería conocer las credenciales ni el protocolo interno de la base de datos. El servidor debe autenticar y autorizar la operación, aplicar las reglas de negocio y controlar qué datos se devuelven.
2.2. Arquitectura de tres capas: el modelo de la web clásica
La arquitectura de tres capas separa la aplicación en:
- Presentación: recibe la interacción y prepara lo que verá o consumirá el cliente.
- Lógica de negocio: aplica las reglas y coordina los casos de uso.
- Datos: consulta, transforma y persiste la información.
La idea importante no es dibujar tres cajas, sino asignar cada decisión a su lugar. Si el precio final de un pedido se calcula en la plantilla HTML, en una API y en un script de base de datos, el sistema puede producir resultados distintos. La regla debe vivir en la lógica de negocio y las otras capas deben utilizarla.
flowchart TB
  P["Presentacion<br/>HTML, CSS, JavaScript, JSON y sesiones"]
  B["Logica de negocio<br/>casos de uso, reglas y autorizacion"]
  D["Datos<br/>repositorios, consultas y persistencia"]
  P -->|"invoca casos de uso"| B
  B -->|"solicita datos"| D
  D -->|"devuelve resultados"| B
  B -->|"prepara respuesta"| P
2.2.1. Capa de presentación
La capa de presentación es el límite con quien utiliza la aplicación o con otro cliente que consume su API. En una web clásica puede incluir:
- las plantillas que generan HTML en el servidor;
- los recursos estáticos, como CSS, JavaScript e imágenes;
- los controladores que traducen una petición HTTP a una operación de la aplicación;
- la serialización de una respuesta a HTML, JSON u otro formato;
- la gestión de aspectos de interacción, como mensajes de validación y navegación.
Su responsabilidad es traducir entre el protocolo externo y el modelo que
entiende la aplicación. Por ejemplo, convierte el texto 42 de una URL en un
identificador y transforma el resultado de un caso de uso en una vista HTML.
La validación en el navegador mejora la experiencia, pero no es una medida de
seguridad suficiente: una petición puede fabricarse con curl o con las
herramientas de desarrollo. El servidor debe volver a validar formato,
permisos, límites y reglas.
La presentación no debería ejecutar consultas SQL ni decidir si una persona puede cancelar un pedido. Puede mostrar un botón solo cuando parece necesario, pero la autorización real pertenece al lado servidor y debe comprobarse en la operación de negocio.
2.2.2. Capa de lógica de negocio
La capa de lógica de negocio contiene el comportamiento que hace que la aplicación sea algo más que un formulario. Sus elementos habituales son:
- casos de uso o servicios de aplicación, como
crearPedidooconsultarCatalogo; - reglas de dominio, como no vender una cantidad superior al stock;
- validaciones que expresan requisitos del negocio;
- coordinación de varias operaciones y límites transaccionales;
- decisiones de autorización relacionadas con la operación solicitada.
Esta capa no debería depender de que la respuesta final sea HTML. El mismo caso de uso puede ser invocado por una interfaz web, una API o una tarea programada. Tampoco debería conocer los detalles de si los datos se guardan en PostgreSQL, MariaDB o un servicio externo: para eso utiliza una abstracción de acceso a datos.
Separar la lógica tiene una consecuencia práctica: se puede probar que «no se puede reservar más stock del disponible» sin arrancar un navegador. La prueba se centra en la regla y no en el formato de la página.
2.2.3. Capa de datos
La capa de datos se ocupa de la comunicación con la persistencia y de traducir entre el modelo de la aplicación y el modelo almacenado. Puede incluir:
- repositorios o DAO (Data Access Object);
- consultas SQL, mapeo de filas y conversión de tipos;
- transacciones, conexiones y agrupaciones de conexiones;
- migraciones y comprobaciones de restricciones;
- integración con otros almacenes, siempre que se documente su contrato.
Esta capa conoce tablas, índices, consultas y errores del motor. La lógica de negocio, en cambio, debería pedir «buscar el producto 42» y no construir una cadena SQL dentro del controlador. Así se reduce el acoplamiento y se puede cambiar la implementación sin reescribir toda la aplicación.
La capa de datos tampoco decide por sí sola una regla completa del negocio. Una
restricción CHECK o una clave única protege la integridad, pero no sustituye a
la lógica de la aplicación ni a la autorización.
2.2.4. Flujo completo de una petición
El recorrido siguiente muestra una petición de detalle de producto. Los nombres son ilustrativos, pero el flujo sirve para analizar una aplicación real:
sequenceDiagram
  actor U as Usuario
  participant C as Navegador
  participant W as Servidor web
  participant A as Aplicacion
  participant R as Repositorio
  participant DB as Base de datos
  U->>C: Solicita producto 42
  C->>W: GET /productos/42
  W->>A: Enruta la peticion
  A->>R: buscarProducto(42)
  R->>DB: Consulta el producto
  DB-->>R: Devuelve la fila
  R-->>A: Devuelve el producto
  A-->>W: Prepara la vista HTML
  W-->>C: 200 OK y contenido
  C-->>U: Muestra el detalle
Si se recibe un 404, la causa puede estar en la ruta, en el controlador, en
la consulta o en la ausencia del producto. Si se recibe un 502, normalmente
hay que investigar la comunicación entre el servidor web y la aplicación. El
diagrama ayuda a formular hipótesis y a guardar evidencias del componente que
falla.
2.3. Reglas de comunicación entre capas
Una organización habitual establece dependencias descendentes:
En el modelo de tres capas, «datos» suele incluir el acceso a datos y la persistencia. Algunos libros separan ambos conceptos y hablan de cuatro capas. No es una contradicción: lo importante es declarar qué responsabilidad se ha asignado a cada bloque y qué dependencias se permiten.
| Regla | Aplicación práctica | Beneficio |
|---|---|---|
| No saltar capas sin motivo | El controlador llama al servicio, no a la base de datos | Evita duplicar reglas y consultas |
| Ocultar detalles | El servicio usa ProductoRepository, no SQL concreto |
Facilita cambiar la tecnología de datos |
| Dependencias controladas | Las capas inferiores no importan plantillas HTML | Reduce el acoplamiento |
| Contratos claros | Cada servicio define entradas, salidas y errores | Facilita pruebas e integración |
| Cohesión | Cada módulo reúne responsabilidades relacionadas | Hace el código más comprensible |
La regla «solo se habla con la capa inmediatamente inferior» es una guía útil, no una ley que ignore el contexto. Una arquitectura puede permitir una dependencia transversal de observabilidad o de configuración. Lo que debe evitarse es que cada componente acceda libremente a todos los demás sin un contrato que explique por qué.
2.4. Capas lógicas y niveles físicos
Estas dos disposiciones pueden representar la misma aplicación lógica:
| Disposición | Presentación | Negocio | Datos | Uso habitual |
|---|---|---|---|---|
| Un equipo de desarrollo | Mismo entorno | Mismo proceso o proyecto | Base local | Aprendizaje y pruebas rápidas |
| Un servidor de aplicación | Servida por Nginx | Proceso de la aplicación | Motor en el mismo host o red privada | Proyecto pequeño |
| Tres niveles físicos | Servidor web | Contenedor o servidor de aplicación | Servicio de base de datos independiente | Aislamiento y escalado selectivo |
| Más niveles | CDN o proxy, web y aplicación | Servicios separados | Base de datos, caché y colas | Cargas mayores o requisitos específicos |
Separar físicamente aumenta el aislamiento y permite escalar una pieza sin replicar todas las demás. A cambio, aparecen redes, puertos, credenciales, latencia, monitorización y más puntos de fallo. No se debe separar una capa solo para que el diagrama parezca más profesional.
2.5. Ventajas e inconvenientes de tres capas
Ventajas principales:
- responsabilidades fáciles de localizar;
- cambios de interfaz con menor impacto sobre las reglas;
- pruebas unitarias y de integración más enfocadas;
- posibilidad de reutilizar la lógica desde varias interfaces;
- protección de la base de datos al situarla detrás del servidor.
Inconvenientes y costes:
- más código de adaptación entre capas;
- configuración y contratos que hay que mantener;
- posible latencia si las capas están en procesos o máquinas distintas;
- riesgo de crear capas artificiales que solo reenvían llamadas;
- una aplicación monolítica por capas sigue siendo una sola unidad de despliegue.
Tres capas no significa tres servidores
La arquitectura por capas describe separación de responsabilidades. Puede desplegarse en uno, dos, tres o más niveles físicos. La elección física se justifica después con requisitos de seguridad, rendimiento, disponibilidad, coste y escalabilidad.
3. Web clásica, monolitos organizados y patrón MVC
Las capas y el monolito responden a preguntas diferentes. Monolito indica que la aplicación se construye y se despliega como una unidad. Capas indica cómo se organiza internamente esa unidad. Por tanto, una aplicación puede ser un monolito bien estructurado por capas.
3.1. Arquitectura monolítica
En una arquitectura monolítica, el código de la aplicación se entrega como una unidad desplegable. Normalmente comparte proceso, memoria y ciclo de vida, aunque los detalles dependen de la tecnología. Una aplicación PHP, un WAR de Java o un servicio Node.js pueden ser monolitos aunque utilicen una base de datos externa.
| Ventajas | Inconvenientes |
|---|---|
| Desarrollo y despliegue iniciales sencillos | Un cambio suele exigir publicar la unidad completa |
| Llamadas internas rápidas | No se escala cada función de forma independiente |
| Depuración local más directa | El acoplamiento puede crecer si no se separan responsabilidades |
| Menos servicios que monitorizar | Un fallo grave puede afectar a toda la aplicación |
| Adecuado para equipos pequeños y MVP | La tecnología y el ciclo de entrega pueden volverse rígidos |
Un monolito no es sinónimo de código desordenado. Un monolito modular, con capas claras, pruebas y contratos internos, suele ser una base más razonable para una aplicación pequeña que una distribución prematura en muchos servicios.
3.2. MVC dentro de una aplicación web clásica
Modelo-Vista-Controlador (MVC) es un patrón para organizar parte del código de una aplicación. No es una alternativa excluyente a las tres capas: puede usarse dentro de un monolito por capas.
| Elemento MVC | Responsabilidad | Relación habitual con las capas |
|---|---|---|
| Modelo | Representar datos y comportamiento del dominio | Negocio y, mediante repositorios, datos |
| Vista | Generar HTML u otra representación para el cliente | Presentación |
| Controlador | Recibir la petición, coordinar el caso de uso y elegir la respuesta | Presentación, con llamada a negocio |
El nombre modelo puede resultar confuso. No significa necesariamente «la tabla de la base de datos». Un modelo de dominio puede representar un pedido y sus reglas, mientras que un repositorio se encarga de guardar ese pedido.
En una web clásica con renderizado en servidor, el flujo habitual es:
- El navegador solicita una ruta.
- El controlador interpreta la petición y valida su formato.
- El controlador invoca un servicio o caso de uso.
- El servicio aplica las reglas y solicita datos al repositorio.
- El controlador entrega el resultado a una vista.
- La vista genera HTML y el servidor devuelve la respuesta.
Un esquema conceptual de ese flujo sería:
Peticion HTTP
    -> Controlador
    -> Servicio de negocio
    -> Repositorio
    -> Base de datos
    -> Servicio de negocio
    -> Vista HTML
    -> Respuesta HTTP
En una aplicación SPA, el navegador ejecuta más lógica JavaScript y el servidor suele devolver JSON mediante una API. Esto cambia la distribución de la presentación, pero no elimina la necesidad de separar las reglas de negocio y proteger los datos en el servidor.
4. De una aplicación por capas a arquitecturas distribuidas
Las arquitecturas distribuidas separan partes de la solución en procesos o servicios que se comunican por red. Esta separación puede resolver una necesidad real, pero también añade latencia, fallos parciales y trabajo de operación.
4.1. Servicios y microservicios
Un sistema basado en servicios divide la funcionalidad en unidades que ofrecen contratos, normalmente APIs o mensajes. Los microservicios llevan esta idea más lejos: cada servicio se centra en una capacidad o límite del dominio y puede desarrollarse, desplegarse y escalarse de manera independiente.
Un microservicio no es simplemente «un contenedor». Un contenedor es una forma de empaquetar y ejecutar software. Para hablar de microservicio debe existir, además, una responsabilidad y un límite claro, un contrato de comunicación y un ciclo de vida suficientemente independiente. Cada microservicio puede estar organizado internamente en capas.
| Característica | Monolito por capas | Microservicios |
|---|---|---|
| Despliegue | Una unidad | Varias unidades independientes |
| Comunicación interna | Llamadas de proceso o biblioteca | Red, API o mensajería |
| Escalado | De toda la aplicación | De cada servicio que lo necesite |
| Datos | Puede compartir una base de datos | Suele evitar una base compartida como contrato interno |
| Operación | Menos componentes | Más logs, métricas, redes y despliegues |
| Fallos | Un fallo puede afectar al conjunto | Se pueden aislar, pero aparecen fallos parciales |
Ventajas: escalado selectivo, equipos más autónomos y despliegues independientes. Costes: descubrimiento de servicios, seguridad entre servicios, compatibilidad de APIs, consistencia de datos, trazabilidad y automatización. Si una aplicación pequeña no necesita estas capacidades, la distribución puede empeorar el resultado.
4.2. Serverless y arquitectura orientada a eventos
En un modelo serverless, el proveedor gestiona los servidores y el equipo despliega funciones o servicios que reaccionan a peticiones y eventos. No significa que no existan servidores: significa que el equipo no administra directamente su infraestructura.
Puede ser útil para tareas esporádicas, como generar una miniatura después de subir una imagen. Sus compromisos incluyen dependencia del proveedor, límites de ejecución, posibles arranques en frío, observabilidad específica y costes que dependen del uso. No es automáticamente la mejor forma de desplegar una web clásica completa.
En una arquitectura orientada a eventos, un componente publica un hecho,
como PedidoCreado, y otros reaccionan sin que el emisor tenga que invocarlos
de forma directa. Esto reduce el acoplamiento, pero obliga a pensar en mensajes
duplicados, orden, reintentos y consistencia eventual.
4.3. Comparación de modelos
| Modelo | Cuándo puede encajar | Riesgo o coste principal |
|---|---|---|
| Dos capas | Aplicaciones pequeñas o sistemas muy sencillos | Acoplamiento entre cliente, lógica y datos |
| Tres capas | Web clásica, aplicaciones empresariales y aprendizaje del despliegue | Más contratos y configuración que dos capas |
| Monolito por capas | MVP, equipo pequeño o dominio todavía cambiante | Escalado y despliegue como unidad |
| Microservicios | Dominio grande, equipos autónomos y necesidad de escalar partes | Complejidad distribuida y operación exigente |
| Serverless | Funciones bajo demanda y eventos con carga variable | Dependencia del proveedor y límites del modelo |
No son opciones totalmente excluyentes. Una aplicación puede ser un monolito por capas, tener una tarea serverless para generar informes y consumir un servicio externo. La decisión debe explicar qué problema resuelve cada modelo.
5. Elegir y representar una arquitectura
Para decidir una arquitectura no conviene comenzar por una herramienta concreta. Primero se analiza la funcionalidad y después se traduce el modelo a procesos, contenedores, máquinas o servicios.
5.1. Caso de referencia: catálogo de aula
Supongamos una aplicación con estas funciones:
- mostrar un catálogo de productos;
- permitir que una persona autenticada cree un pedido;
- impedir pedidos superiores al stock disponible;
- conservar productos y pedidos en una base de datos;
- funcionar con pocas personas usuarias en el aula;
- poder levantar el entorno de forma reproducible.
Para este caso, una decisión razonable es un monolito organizado en tres capas, con el servidor web como punto de entrada y una base de datos en una red interna. Docker Compose puede ayudar a reproducir el entorno, pero no convierte el monolito en microservicios.
Decisión razonada
Para una aplicación de aula con pocas personas usuarias, un monolito por capas permite practicar presentación, negocio, datos y despliegue sin añadir la complejidad operativa de un clúster de microservicios. La decisión se revisaría si aparecieran requisitos de escalado independiente, equipos separados o ciclos de publicación muy distintos.
flowchart TB
  U["Navegador del alumnado"] -->|"HTTPS"| W["Nginx<br/>estaticos y proxy"]
  W -->|"Peticion dinamica"| P
  subgraph CAPAS["Aplicacion monolitica por capas"]
    P["Presentacion<br/>controladores y vistas"] --> B["Negocio<br/>pedidos y stock"]
    B --> D["Datos<br/>repositorios"]
  end
  D -->|"SQL en red interna"| DB["MariaDB o PostgreSQL"]
La elección se justifica porque el número de usuarios es reducido, el dominio es manejable y el equipo necesita aprender el flujo completo sin asumir el coste de operar muchos servicios. Si la generación de informes creciera y necesitara escalar de forma independiente, se podría estudiar extraerla como servicio o función; no es una obligación inicial.
5.2. Método de análisis
-
Identificar la funcionalidad: enumera las operaciones, las personas usuarias, los datos y los requisitos de disponibilidad.
No empieces por «usaremos microservicios». Explica primero qué debe hacer la aplicación y qué consecuencias tendría un fallo, una actualización o un aumento de carga.
-
Asignar responsabilidades: coloca cada operación en presentación, negocio o datos.
Por ejemplo, mostrar un mensaje de error pertenece a presentación; decidir si hay stock pertenece a negocio; obtener el stock almacenado pertenece a datos.
-
Definir comunicaciones y límites: documenta qué llama a qué, qué datos atraviesan cada contrato y qué componentes quedan en una red interna.
El diagrama debe indicar, al menos, el sentido de las peticiones, el acceso a los datos y los puntos que se publican. No basta con dibujar cajas sin relaciones.
-
Elegir la distribución física: decide qué se ejecuta junto y qué se separa en procesos, contenedores o servicios.
En esta decisión se comparan seguridad, rendimiento, coste, disponibilidad, facilidad de mantenimiento y capacidad real del equipo. La separación física se introduce cuando resuelve una necesidad concreta.
-
Anotar ventajas, límites y alternativa: registra por qué se elige el modelo y en qué situación habría que revisarlo.
Esta justificación convierte el diagrama en una decisión técnica que otra persona puede revisar y no en una colección de tecnologías de moda.
5.3. Ficha mínima de una decisión arquitectónica
| Pregunta | Ejemplo en el catálogo |
|---|---|
| ¿Qué funcionalidad se necesita? | Consultar productos y crear pedidos |
| ¿Qué componentes participan? | Navegador, Nginx, aplicación y base de datos |
| ¿Qué datos persisten? | Productos, cuentas y pedidos |
| ¿Qué se expone a Internet? | HTTPS y el punto de entrada web |
| ¿Qué queda interno? | Base de datos y red entre servicios |
| ¿Qué ocurre si falla un componente? | Se documenta la respuesta y la recuperación |
| ¿Cómo se escala? | Primero verticalmente o replicando la aplicación si es necesario |
| ¿Qué alternativa se descarta? | Microservicios prematuros por su coste operativo |
6. Buenas prácticas
Para trabajar este contenido con criterio, conviene aplicar estas buenas prácticas:
- Separar responsabilidades: coloca cada decisión en la capa que puede mantenerla y probarla con claridad.
- Mantener la base de datos detrás del servidor: no publiques sus puertos ni sus credenciales para que el navegador consulte directamente.
- Distinguir capas de niveles físicos: indica si un diagrama representa organización lógica, despliegue o ambas cosas.
- Definir contratos: documenta entradas, salidas, errores y permisos entre componentes.
- Empezar con la solución necesaria: un monolito por capas puede ser una decisión profesional cuando reduce complejidad y riesgo.
- Representar flujos, no solo cajas: muestra peticiones, respuestas, consultas, redes y puntos de entrada.
- Justificar los compromisos: relaciona cada elección con funcionalidad, mantenimiento, coste, disponibilidad o escalabilidad.
- Preparar la evolución: deja claro qué señal justificaría separar una función, replicar una aplicación o cambiar de modelo.
7. Errores frecuentes
| Error frecuente | Por qué ocurre | Cómo evitarlo |
|---|---|---|
| Confundir tres capas con tres servidores | Se mezclan responsabilidades lógicas y despliegue físico | Indica siempre qué es capa y qué es nivel físico |
| Llamar microservicios a cualquier conjunto de contenedores | Se confunden empaquetado y arquitectura | Describe el límite de negocio, el contrato y el ciclo de despliegue de cada servicio |
| Poner SQL en controladores o plantillas | Se busca una solución rápida y se mezclan responsabilidades | Usa servicios de negocio y repositorios |
| Validar solo en JavaScript | Se olvida que el cliente no es confiable | Repite la validación y la autorización en el servidor |
| Exponer la base de datos | Se confunde conectividad interna con publicación | Mantén los datos en una red interna y publica solo la entrada necesaria |
| Creer que las capas garantizan seguridad | La separación facilita el control, pero no cifra ni autoriza por sí sola | Añade HTTPS, autenticación, autorización, secretos y mínimo privilegio |
| Crear un servicio por cada clase o tabla | Se busca dividir sin un límite funcional | Extrae servicios por capacidades del dominio y necesidades reales |
| Elegir Kubernetes o cloud antes de analizar el problema | Se empieza por la herramienta | Documenta primero requisitos, equipo, coste y alternativa |
| Pensar que un monolito siempre es mala arquitectura | Se confunde tamaño con calidad | Valora un monolito modular si simplifica el desarrollo y el despliegue |
8. Resumen y conclusión
En este tema has aprendido que:
- el modelo cliente-servidor organiza la relación entre quien solicita un servicio y quien lo proporciona;
- dos capas reducen componentes, pero pueden concentrar lógica y datos;
- tres capas separan presentación, lógica de negocio y datos, y esta separación es especialmente útil en las webs clásicas;
- las capas son responsabilidades lógicas y no obligan a tener tres servidores;
- un monolito puede estar bien organizado por capas y no equivale a código desordenado;
- MVC puede organizar la interacción web dentro de una aplicación por capas;
- microservicios y serverless resuelven necesidades diferentes y añaden costes de operación que deben justificarse;
- un diagrama útil muestra componentes, comunicaciones, datos y límites, y una buena decisión explica también sus inconvenientes.
Idea clave
Primero se decide qué necesita la aplicación y quién es responsable de cada tarea. Después se elige cómo desplegar esas responsabilidades. Para una web clásica, comenzar con tres capas bien separadas suele aportar claridad sin asumir la complejidad de una arquitectura distribuida.
9. Para seguir practicando
- Analiza la arquitectura de Guestbook con Docker e identifica sus capas lógicas y sus servicios.
- Compara el flujo de Tomcat detrás de Nginx con el recorrido de una petición descrito en este tema.
- Revisa WordPress con MariaDB y señala qué parte corresponde a presentación, aplicación y datos.
- Dibuja la arquitectura de una aplicación de aula y escribe una justificación de cinco líneas que incluya una ventaja, un límite y una alternativa.
- Amplía los modelos en Arquitecturas web y fundamentos del despliegue, teniendo en cuenta que este apunte profundiza la separación de tres capas para la secuencia de la UD 3.
Bibliografía y fuentes
- Normativa del módulo 0614.
- Material propio: arquitecturas web y fundamentos del despliegue.
- Presentación publicada sobre arquitecturas web.
- José Luis Sánchez: Despliegue de aplicaciones web.
- Fowler, M. (2002). Patterns of Enterprise Application Architecture. Addison-Wesley.
- The Twelve-Factor App, como referencia para relacionar arquitectura y operación.
Presentación
Consulta la presentación DAW-U3.1 - Arquitecturas web, que desarrolla el modelo cliente-servidor, las tres capas, MVC, las arquitecturas distribuidas y el método para justificar una decisión.